
مدلهای استدلالی
مدلهای پیشرفته استدلال و حل مسئله موجود از طریق AvalAI را کاوش کنید.
مقدمه
مدلهای استدلالی مدلهای زبان بزرگی هستند که برای مصرف compute بیشتر روی استدلال پیچیده پیش از پاسخ آموزش دیدهاند. reasoning آنها را یک فرایند داخلی بدانید: پاسخ نهایی، دلیل کوتاه، citation یا checklist بخواهید، اما از مدل نخواهید chain-of-thought پنهان را آشکار کند. آنها در حل مسائل پیچیده، کدنویسی، استدلال علمی و برنامهریزی چند مرحلهای برای گردش کارهای عاملی (agentic) برتری دارند.
AvalAI دسترسی به چندین مدل با قابلیت استدلال از ارائهدهندگان مختلف را فراهم میکند:
مدلهای OpenAI:
gpt-6.1-sol: نسخه تازه Sol برای استدلال در کدنویسی و اسناد حرفهای با حداکثر ۹۲۲٬۰۰۰ توکن ورودی و ۱۲۸٬۰۰۰ توکن خروجی؛ پشتیبانی کامل Chat Completions، Messages و Responses از سطح ۱gpt-6-sol: استدلال GPT-6 با هزینه کمتر برای عاملهای کدنویسی، کار حرفهای، استفاده از رایانه و مکالمههای طولانی؛ حداکثر ۹۲۲٬۰۰۰ توکن ورودی و ۱۲۸٬۰۰۰ توکن خروجی، با پشتیبانی کامل Chat Completions، Messages و Responsesgpt-6-luna: استدلال کمهزینهتر GPT-6 برای دستیارهای پرترافیک، پردازش سند و بخشهای کوچکتر کار کدنویسی؛ با همان محدودیتهای ثبتشده و پشتیبانی نقاط پایانی Solgpt-6-astra: توانمندترین مدل GPT-6 از OpenAI برای استفاده دشوار از رایانه، مهندسی نرمافزار، کار حرفهای، علوم، ریاضیات، امنیت سایبری، بازیابی از زمینه طولانی و استدلال ابزارمحور؛ با پشتیبانی کامل در Chat Completions، Messages و Responsesgpt-5.6-sol: توانمندترین مدل نسل پیشین GPT-5.6 برای کدنویسی عاملی دشوار، کار دانشی، استدلال علمی و هماهنگی ابزارها، پنجره زمینه ۱Mgpt-5.6-terra: مدل متعادل GPT-5.6 برای استدلال تولیدی روزمره و گردشکارهای عاملی، پنجره زمینه ۱Mgpt-5.6-luna: مدل مقرونبهصرفه GPT-5.6 برای استدلال پرترافیک، پشتیبانی و گردشکارهای اسنادی، پنجره زمینه ۱Mgpt-5.5: پرچمدار قبلی OpenAI با استدلال در سطح جدیدترین فناوری در کدنویسی عاملی، کار دانشی، استفاده از کامپیوتر و تحقیقات علمی (تلاش قابل تنظیم: none/low/medium/high/xhigh)، پنجره زمینه ۱Mgpt-5.4-pro: مدل GPT-5.4 با بالاترین سطح استدلال برای کار حرفهای پیچیده، پنجره زمینه ۱.۰۵M، سطوح تلاش medium/high/xhighgpt-5.4: مدل frontier برای استدلال و گردشکارهای عاملی با تلاش قابل تنظیم (none/low/medium/high/xhigh)، پنجره زمینه ۱.۰۵Mgpt-5.4-mini: مدل سریع و مقرون به صرفه با پشتیبانی از استدلال (سطوح تلاش بدون، کم، متوسط)، زمینه ۴۰۰Kgpt-5.4-nano: سریعترین و مقرون به صرفهترین مدل با استدلال پایه (سطوح تلاش بدون، کم)، زمینه ۴۰۰Kgpt-5-pro: مدل استدلالی پیشرفته OpenAI با قابلیتهای تفکر گسترده برای حل مسائل سطح تخصصی (کاربران سطح ۲ به بالا، فقط API Responses)gpt-5.3-codex: توانمندترین مدل کدنویسی عاملی OpenAI با پشتیبانی از توکنهای استدلال (فقط API Responses)o4-mini: استدلال پیشرفته با کارایی بهبود یافتهo3: قابلیتهای استدلالی متعادل با عملکرد خوبo3-mini: مدلی کوچکتر و سریعتر، معمولا با هزینه کمتر به ازای هر توکن
مدلهای Gemini گوگل:
gemini-4-argon: پرچمدار جدید گوگل برای حفظ استدلال عمیق، مهندسی نرمافزار، کار دانشی تخصصی و تحلیل چندوجهی؛ با سقف مستقل ۱٬۰۴۸٬۵۷۶ توکن ورودی و ۱٬۰۴۸٬۵۷۶ توکن خروجی در فهرست و پشتیبانی Gemini بومی، Chat Completions، Messages و Responsesgemini-3.8-flash: مدل Flash گوگل در سپتامبر ۲۰۲۶ برای کدنویسی بلندمدت، عاملهای خودکار، استدلال دقیق چندمرحلهای، کار تخصصی حرفهای و استفاده تکرارشونده از ابزارgemini-flash-latest: نام مستعاری با بهروزرسانی خودکار که اکنون بهgemini-3.8-flashاشاره میکندgemini-3.6-flash: مدل همهکاره استدلالی Flash گوگل در ژوئیه ۲۰۲۶ برای کدنویسی عاملی، کار دانشی، تحلیل چندوجهی، استفاده کارآمد از ابزار و زمینه ۱Mgemini-3.5-flash-lite: سریعترین و مقرونبهصرفهترین مدل استدلالی کلاس Gemini 3.5 برای زیرعاملهای پرترافیک، پردازش سند، استخراج و بارهای کاری کمتأخیرgemini-3.5-flash: مدل استدلالی Flash گوگل در مه ۲۰۲۶ با سطوح تفکر قابل تنظیم، عملکرد قوی در کدنویسی و استفاده عاملمحور از ابزار، ورودی چندوجهی و زمینه ۱Mgemini-3.1-pro-preview: مدل پیشرفته کلاس Pro گوگل (فوریه ۲۰۲۶) با استدلال چندوجهی بومی، عملکرد عاملی قوی، کدنویسی پیشرفته و درک زمینه طولانیgemini-3.1-flash-lite: مدل استدلالی پایدار و مقرونبهصرفه برای وظایف عاملی سبک و پرتکرار با تأخیر بسیار پایینgemini-3.1-flash-lite-preview: alias پیشنمایش Gemini 3.1 Flash-Lite با همان قیمتگذاری و قابلیتهاgemini-2.5-pro: دارای قابلیتهای تفکر و استدلال پیشرفتهgemini-2.5-flash: اولین مدل استدلال ترکیبی گوگل با بودجههای تفکر قابل تنظیم
مدلهای Anthropic:
claude-haiku-5-5: مدل کوچک برای خلاصهسازی پرتعداد، دستهبندی، پشتیبانی زنده و زیرعاملهای کدنویسی با تلاش قابل تنظیم و پشتیبانی Chat Completions، Messages و Responses؛ ورودی درخواست تا ۱۰۰ هزار توکن تعرفه پایینتری داردclaude-sonnet-5-5: مدل خانواده Claude 5.5 برای کدنویسی با دامنه مشخص و کار اسنادی، با حداکثر یکمیلیون توکن ورودی و ۱۲۸ هزار توکن خروجی؛ پشتیبانی کامل Chat Completions و Messages و جزئی Responses از سطح ۱، همراه با مهاجرتbetween_toolsبرای گردشکارهای قبلی با تفکر غیرفعالclaude-opus-5-5: جدیدترین پرچمدار Opus از Anthropic با پنجره ورودی یکمیلیونتوکنی، حداکثر خروجی ۱۲۸ هزار توکن، تفکر تطبیقی همیشهفعال، تلاش پیشفرضmediumو پشتیبانی کامل Chat Completions، Messages و Responses از سطح ۱؛ برای کدنویسی طولانیمدت، راستیآزمایی و کار دانشی طراحی شده استclaude-fable-5-1: پرچمدار عمومی جدید Anthropic با پنجره ورودی ۱M، ظرفیت خروجی ۱۲۸K، تفکر تطبیقی همیشهفعال، تلاش قابل تنظیم تا سطحmaxو توانایی بهتر در کدنویسی بلندمدت، کار دانشی، پژوهش علمی و راستیآزمایی؛ در دسترس حسابهای سطح ۲ و بالاترclaude-opus-5: پرچمدار Opus شرکت Anthropic با پنجره ورودی ۱M، ظرفیت خروجی ۱۲۸K، تفکر تطبیقی، تلاش قابل تنظیم، بررسی دقیق و توانایی قوی در کدنویسی بلندمدت، کار دانشی، استفاده از کامپیوتر و تحلیل علمیclaude-opus-4-8: پرچمدار قبلی Opus با تفکر تطبیقی، ۵ سطح تلاش (پایین/متوسط/بالا/فوقبالا/حداکثر)، تلاش پیشفرضhigh، پیامهای سیستمی میان مکالمه و کدنویسی عاملی افق بلند قویclaude-opus-4-7: مدل پرچمدار قبلی با تفکر تطبیقی، ۵ سطح تلاش (پایین/متوسط/بالا/فوقبالا/حداکثر) و بودجه وظایفclaude-sonnet-5: مدل نسل پیشین Sonnet با تفکر تطبیقی و سطوح تلاش قابل تنظیم؛ تلاش بالاتر میتواند در برخی وظایف با Opus 4.8 برابری کند، با قیمتگذاری سطح Sonnet که پایینتر استclaude-sonnet-4-6: قابلیتهای استدلالی قوی با کارایی بهترclaude-haiku-4-5: استدلال سریع و کارآمد برای استقرارهای حساس به هزینه
مدلهای Moonshot AI:
kimi-k3: پرچمدار جدید Moonshot AI با ۲٫۸ تریلیون پارامتر، زمینه ۱ میلیون توکنی، بینایی بومی، استدلال همیشهفعال، کدنویسی بلندمدت، خروجی ساختاریافته و فراخوانی ابزارkimi-latest: alias پایدار که اکنون با همان قابلیتها و قیمت بهkimi-k3اشاره میکند
برای Kimi K3 از فیلد سطح بالای reasoning_effort: "max" استفاده کنید. K3 فعلا فقط سطح max را پشتیبانی میکند و thinking در آن همیشه فعال است. پارامتر قدیمی thinking مربوط به K2.x یا فیلدهای sampling ثابت مانند temperature و top_p را استفاده نکنید. در workflowهای چندنوبتی و ابزارمحور، پیام کامل assistant را به درخواست بعدی اضافه کنید تا زمینه reasoning و tool call حفظ شود.
مدلهای DeepSeek:
deepseek-v4.1-flash: پیشنهاد برای یکپارچهسازیهای جدید؛ با بینایی بومی، حالتهای تفکری و غیرتفکری، ابزارها و حافظه نهان پرامپت. معماری ترکیب متخصصان با رمزگذار–رمزگشای علّی آن ۵۵۲ میلیارد پارامتر کل دارد؛ ۸ میلیارد برای ورودی و ۱۶ میلیارد برای خروجی فعالاند. فهرست AvalAI سقف ۱٬۰۰۰٬۰۰۰ توکن ورودی و ۳۹۳٬۲۱۶ توکن خروجی را ثبت کرده است؛ ارائهدهنده خروجی را 384K مینامد. مدل پایه فعلیDeepSeek-V4.1-Flash-1017است.deepseek-flash: شناسه موجود AvalAI که اکنون آن هم ازDeepSeek-V4.1-Flash-1017استفاده میکند. برای هیچیک از دو شناسه Flash نیازی به تغییر کد کلاینت نیست و قیمتها ثابت ماندهاند: شناسه، نقطه پایانی و قالب درخواست فعلی را نگه دارید. نرخ هر میلیون توکن همچنان $0.15 ورودی، $0.003 ورودی از حافظه نهان و $0.60 خروجی است. نام مدل پایه شناسه جدید API نیست؛ این ارتقا مقدار تازهای برای تلاش یا تغییری برای سایر نامهای مستعار تعیین نمیکند. گردشکارهای مهم استدلالی و ابزارمحور را دوباره آزمایش کنید. خبر ۲۶ مهر را ببینید.deepseek-v4-pro: اطلاعیه جداگانه ۲۰ شهریور، هدایت بهdeepseek-v4.1-flashو اعمال تعرفه آن را از ۱۴۰۵-۰۶-۲۳ / (2026-09-14) ساعت 04:00 UTC ثبت کرده است؛ مشخصات پیشین V4-Pro-0813 تاریخیاند، نه مشخصات دو شناسه Flash ارتقایافته.deepseek-v4-flash: مسیر نسل پیشین V4؛ سابقه نسخه 0731 در راهنمای ارائهدهنده آمده است. بازنشستگی در سرویس مستقیم ارائهدهنده بهتنهایی اعلام تغییر مسیر جدید در AvalAI نیست.deepseek-reasonerوdeepseek-chat: نامهای مستعار سازگار که طبق سیاست AvalAI در ۱۴۰۵-۰۵-۲۳ / (2026-08-14) حفظ شدهاند؛ این سیاست هدایت آنها بهترتیب بهdeepseek-v4-proوdeepseek-v4-flashرا ثبت کرده است. بازنشستگی سرویس مستقیم در ۱۴۰۵-۰۵-۰۲ / (2026-07-24) سیاست نامهای مستعار AvalAI نیست و تغییر دیگری برای این نامها در اینجا اعلام نمیشود.
مدلهای xAI:
grok-4.7: تازهترین مدل xAI برای عاملهای کدنویسی طولانیمدت، راستیآزمایی، تهیه سند و ارائه و تحلیل فنی؛ با بینایی، استدلال، ابزارها، خروجی ساختاریافته و حافظه نهان و سقفهای جداگانه ورودی و خروجی هر کدام ۵۰۰٬۰۰۰ توکن. پشتیبانی Chat Completions و Messages کامل و پشتیبانی Responses جزئی است.grok-4.6: برای عاملهای طولانیمدت، کدنویسی، کار دانشی و پروژههای بصری تعاملی، نه تولید تصویر. بینایی، استدلال، ابزارها، خروجی ساختاریافته و حافظه نهان را پشتیبانی میکند؛ سقف ورودی و خروجی در فهرست AvalAI هر کدام ۵۰۰٬۰۰۰ توکن است.grok-4.5: مدل نسل پیشین XAI برای کدنویسی، وظایف عاملی و کار دانشی با زمینه ۱M، سرویسدهی سریع، پشتیبانی Chat Completions و پشتیبانی جزئی Responsesgrok-4.3: مدل استدلالی پرچمدار XAI با پنجره زمینه ۱M، فراخوانی تابع، خروجیهای ساختاریافته و قیمتگذاری وابسته به زمینه بالای ۲۰۰K توکنgrok-4.20-reasoning: نسخه پایدار با سرعت پیشرو در صنعت و استدلال داخلی، پنجره زمینه ۲م، کمترین نرخ توهمزاییgrok-4.20-non-reasoning: نسخه پایدار بدون استدلال برای وظایفی که به استدلال داخلی گسترده نیاز ندارند، پنجره زمینه ۲م
مدلهای MiniMax:
minimax-m3: مدل پرچمدار جدید با قابلیتهای کدنویسی و عاملی پیشرو، پنجره زمینه ۱م (معماری MSA)، ورودی چندوجهی بومی و تفکر قابل تغییرminimax-m2.7: مدل استدلالی انقلابی خود-تکامل (اولین مدلی که عمیقا در تکامل خود شرکت میکند)، ۵۶.۲۲٪ SWE-Pro، پشتیبانی از تیمهای عاملminimax-m2.7-highspeed: نسخه فوقسریع خود-تکامل (~۱۰۰ توکن در ثانیه سرعت خروجی)minimax-m2.5: مدل شاخص نسل قبل با عملکرد SOTA در کدنویسی (۸۰.۲٪ SWE-Bench Verified) و بهرهوری واقعیminimax-m2.5-lightning: نسخه فوق سریع استدلالی (~۱۰۰ توکن در ثانیه سرعت خروجی)
مدلهای Z.AI:
glm-5.3-flash: مدل استدلالی چندوجهی و کارآمد با ۳۲۰B پارامتر کل و ۱۸B پارامتر فعال، 991,000 توکن ورودی، توانمندی کدنویسی و عاملها و پشتیبانی از ابزارglm-5.3: جدیدترین مدل پرچمدار استدلالی با تفکر اجباری، زمینه ۱ میلیون توکنی، کدنویسی و عملکرد عاملی بلندمدت قویتر و سطح استدلالlow،highیاmaxglm-5.2: مدل پرچمدار استدلالی با زمینه ۱ میلیون توکنی، کدنویسی پیشرو و مهندسی عاملی بلندمدتglm-5.1: استدلال پیشرفته با ۵۸.۴٪ SWE-Bench Pro، بهینهسازی بلندمدت برای مهندسی عاملیglm-5v-turbo: استدلال چندوجهی و درک بینایی با پردازش تصویری پرسرعتglm-5-turbo: استدلال بهینهشده برای OpenClaw، فراخوانی ابزار، وظایف پایدار و اجرای زنجیرههای طولانی
مدلهای Alibaba:
qwen3.8-flash: مدل مدیریتشده کمهزینه و نام مستعارqwen3.8-flash-nextبا ۱۲۵ میلیارد پارامتر کل و ۶ میلیارد فعال از جنس MoE، توجه ترکیبی GDN + QSA، ورودی بینایی، تفکر پیشفرض فعال، زمینه ۲۶۲K و مقدارهایlow،mediumوxhighبرایreasoning_effortqwen3.8-27b: مدل متراکم فشرده ۲۷ میلیارد پارامتری بینایی-زبان با کنترل انعطافپذیر تفکر، زمینه ۲۶۲K و مقدارهایlow،mediumوxhighبرایreasoning_effortqwen3.8-2.4t-a95b: مدل پایه وزنباز زیرساخت Qwen3.8-Max با ۲٫۴ تریلیون پارامتر کل و ۹۵ میلیارد پارامتر فعال، ورودی فقط متن، تفکر همیشه فعال و اجباری، زمینه ۲۶۲K و مقدارهایlow،mediumوxhighبرایreasoning_effortqwen3.8-max: جدیدترین پرچمدار مدیریتشده ۲٫۴ تریلیون پارامتری برای کدنویسی بلندمدت، کار حرفهای، استدلال چندوجهی و برنامهریزی عاملی، با تفکر ترکیبی اختیاری از طریقenable_thinking، زمینه ۱ میلیون و حداکثر خروجی ۱۲۸Kqwen3.7-max: مدل پرچمدار قبلی پایه عامل، تفکر ترکیبی از طریقenable_thinking، ۹۲.۴ GPQA Diamond، ۹۷.۱ HMMT، زمینه ۱ میلیونqwen3-max: مدل پرچمدار Qwen3 Max برای استدلال پیچیده و گردشهای کاری عاملی، تفکر ترکیبی از طریقenable_thinking، زمینه ۲۶۲ هزارqwen3.6-plus: مدل کدنویسی عاملی با ۷۸.۸٪ SWE-bench Verified، زمینه پیشفرض ۱ میلیون، توسعه وب پیشروqwen3.6-flash: مدل سریع با تفکر ترکیبی و سوئیچenable_thinking، پنجره زمینه ۱ میلیونqwen3.6-max-preview: پیشنمایش پرچمدار با تفکر ترکیبی، توانمندترین مدل Qwen3.6qwen3.6-35b-a3b: MoE وزن-باز (۳۵B کل/۳B فعال) با حالت تفکر، زمینه ۲۵۶ هزارqwen3.6-27b: مدل Dense بینایی-زبان برای استدلال با زمینه ۲۵۶ هزار
مدلهای Fireworks.ai:
muse-glimmer-30b: مدل dense چندوجهی و عاملی Meta با حدود ۳۰B پارامتر، استفاده از ابزار، بازیابی از شکست، بیش از ۱۰۰ زبان، زمینه بیشتر از ۱۳۱K و سطوح reasoning قابل تنظیمlow،medium،highوxhighnemotron-3.5-lightning: مدل hybrid MoE کارآمد NVIDIA با ۳۰B پارامتر کل و ۳B فعال، زمینه ۲۶۲K در AvalAI، استفاده از ابزار، کدنویسی و reasoning عاملی؛ پیادهسازی upstream امکان روشن یا خاموش کردن thinking را داردnemotron-3-ultra: مدل پرچمدار بزرگمقیاس Nemotron از NVIDIA برای استدلال پیچیده و گردشکارهای عاملی، سرویسدهیشده از طریق Fireworks.ai
برای Muse Glimmer فقط زمانی که route انتخابی این فیلدها را میپذیرد، با مقادیر پیشنهادی upstream یعنی temperature: 1.0، top_p: 0.95 و top_k: 64 شروع کنید. برای Nemotron 3.5 Lightning از temperature: 1.0 و top_p: 0.95 شروع کنید. عبور کنترلهای thinking اختصاصی provider را در همه endpointهای AvalAI فرض نکنید؛ پاسخ را بررسی و فیلدهای پشتیبانینشده را حذف کنید.
توجه: برخی مدلهای پیشرفته مانند o1-pro ممکن است ویژگیهای منحصربهفرد و نقاط پایانی API خاصی داشته باشند (مثلا معادل AvalAI برای Responses API). برای جزئیات، به مستندات مدل مورد نظر و مرجع API AvalAI مراجعه کنید.
چه زمانی از مدلهای reasoning استفاده کنیم
مدلهای reasoning برای کارهایی مناسباند که صحت پاسخ به برنامهریزی، رفع ابهام یا سنجش دقیق trade-offها وابسته است. از آنها استفاده کنید وقتی نیاز دارید:
- حل مسئله پیچیده: تصمیمهای ریاضی، علمی، مالی، حقوقی، policy یا مهندسی با محدودیتهای زیاد.
- ترکیب زمینه طولانی: یافتن رابطهها در قراردادها، گزارشها، transcriptها، ticketها یا سندهای بازیابیشده.
- برنامهریزی عاملی: تصمیمگیری درباره ابزارها، شکستن workflow یا واگذاری گامها به مدلهای اجرایی سریعتر.
- بازبینی و debugging کد: بررسی diffهای چندفایلی، ریشهیابی خطاها یا اعتبارسنجی patchهای تولیدشده.
- ارزیابی: داوری پاسخ مدلها بر اساس rubricهای ظریف یا پاسخهای مرجع.
مدلهای reasoning را مانند برنامهریز و مدلهای GPT-style سریعتر را مانند مجری در نظر بگیرید. از برنامهریز برای ابهام، strategy ابزارها، تفسیر policy، ترکیب زمینه طولانی یا اعتبارسنجی نهایی استفاده کنید. از مجری برای extraction، بازنویسی، classification، formatting و گامهای دقیقا تعریفشدهای استفاده کنید که سرعت و هزینه از reasoning عمیق مهمترند. بسیاری از سیستمهای production هر دو را ترکیب میکنند: مدل reasoning برنامهریزی یا اعتبارسنجی میکند و مدل کمتأخیرتر گامهای ساده را اجرا میکند.
پرامپتنویسی مؤثر برای مدلهای reasoning
مدلهای reasoning نسبت به مدلهای کلاسیک GPT-style به سبک پرامپت متفاوتی نیاز دارند:
- پرامپت را ساده و مستقیم نگه دارید؛ قبل از افزودن مثالها، zero-shot شروع کنید.
- قوانین برنامه را در پیام
developerو وظیفه کاربر را در پیامuserقرار دهید. - برای جدا کردن قوانین، زمینه و مثالها از تیترهای Markdown، tagهای XML یا delimiterهای دیگر استفاده کنید.
- محدودیتها، معیار موفقیت، ابزارهای موجود و محتوای مورد انتظار پاسخ نهایی را دقیق مشخص کنید.
- از درخواست chain-of-thought پنهان یا «step by step فکر کن» خودداری کنید؛ بهجایش دلیل کوتاه، checklist پاسخ یا شواهد دارای citation بخواهید.
- اگر یک snapshot مدل reasoning خروجی Markdown را کم میکند اما UI شما Markdown میخواهد، خط اول پیام developer را با
Formatting re-enabledشروع کنید.
قابلیتهای ارائهدهندگان متفاوت است. مدلهای OpenAI در /v1/responses از reasoning.effort استفاده میکنند؛ Kimi K3 از فیلد سطح بالای reasoning_effort: "max" استفاده میکند؛ DeepSeek-V4-Flash-0731 مقدارهای low، high و max را میپذیرد. مدل مدیریتشده qwen3.8-max از enable_thinking با الزامات استریمینگ وابسته به route استفاده میکند، مدلهای qwen3.8-flash و qwen3.8-27b تفکر را بهصورت پیشفرض فعال دارند و همراه enable_thinking مقدارهای low، medium و xhigh را برای reasoning_effort میپذیرند، و مدل وزنباز و فقط متن qwen3.8-2.4t-a95b تفکر اجباری دارد و همین مقدارها را برای reasoning_effort میپذیرد. قبل از کپی کردن پارامترها بین خانواده مدلها، بخش provider را بررسی کنید.
Gemini 4 Argon
برای مسئلههایی که از استدلال پیوسته سود میبرند، مانند مهندسی در سطح مخزن، پژوهش چندمرحلهای، تحلیل اسناد حرفهای و بررسی شواهد چندوجهی، از gemini-4-argon استفاده کنید. گوگل بر کار حقوقی و مالی، درک ویدیوهای طولانی، تحلیل نمودار و امنیت دفاعی در محدوده مجاز تأکید کرده است. نتایج ارزیابی ارائهدهنده را اطلاعات زمینهای بدانید، نه تضمین عملکرد عامل یا برنامه خود.
| قابلیت یا محدودیت | Argon در AvalAI |
|---|---|
| حداکثر توکن ورودی در فهرست | 1,048,576 |
| حداکثر توکن خروجی در فهرست | 1,048,576 |
| ورودیها / خروجی | متن، تصویر، صدا، ویدیو، PDF / متن |
| قالبهای پشتیبانیشده | Gemini بومی /v1beta/models، /v1/chat/completions، /v1/messages، /v1/responses |
| استدلال و ابزارها | استدلال، فراخوانی تابع، خروجی ساختاریافته، حافظه نهان پرامپت، پخش جریانی |
استدلال و بودجه خروجی
- با پیشفرضها شروع کنید، نه کنترل حدسی. این انتشار قابلیت استدلال را تأیید میکند، اما فهرست مقدارهای تلاش، بودجه تفکر یا تلاش پیشفرض Argon را تعیین نمیکند. تنظیمات
thinkingBudget،thinkingLevelیاreasoning_effortمدلهای قدیمی Gemini را با فرض سازگاری به این مدل منتقل نکنید. - شواهد مفید بخواهید. هدف، محدودیت، منابع و معیار پذیرش را ارائه دهید. نتیجه، دلیل کوتاه، استناد و چکلیست راستیآزمایی بخواهید، نه زنجیره استدلال پنهان.
- برای استدلال و پاسخ با هم بودجه تعیین کنید. استدلال پنهان از توکن خروجی صورتحسابشده و ظرفیت خروجی مصرف میکند. سقف بزرگ به معنی مصرف کامل آن در هر درخواست نیست؛ با کنترل تأییدشده قالب انتخابی، سقف خروجی واقعبینانه تعیین کنید و سپس مصرف و وضعیت تکمیل را بررسی کنید.
- دو سقف را جمع نکنید. محدودیت ورودی و خروجی دو مقدار مستقل در فهرستاند، نه تضمین درخواست با مجموع آنها. برای نتیجه ابزارها، رشد مکالمه، استدلال و پاسخ نهایی فضا باقی بگذارید.
- اجرای عامل را محدود نگه دارید. عاملهای طولانیمدت به مجوز ابزار، اجرای ایزوله، مهلت پاسخ، نقاط بازبینی و بررسی پیش از تغییرات مهم نیاز دارند. پشتیبانی نقطه پایانی به معنی در دسترس بودن تمام ابزارهای میزبانیشده یا رفتارهای دارای وضعیت ذخیرهشده نیست.
نمونه پایه Responses
Responses از input استفاده میکند و SDK OpenAI متن نهایی را در response.output_text قرار میدهد. اگر Chat Completions، Messages یا Gemini بومی را انتخاب میکنید، همان شناسه مدل را با ساختار متناسب آن قالب به کار ببرید.
curl https://api.avalai.ir/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $AVALAI_API_KEY" \
  -d '{
    "model": "gemini-4-argon",
    "input": "Review a database migration plan: identify failure modes and give a concise verification checklist."
}'import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["AVALAI_API_KEY"],
base_url="https://api.avalai.ir/v1",
)
response = client.responses.create(
model="gemini-4-argon",
input="Review a database migration plan: identify failure modes and give a concise verification checklist.",
)
print(response.output_text)import OpenAI from "openai";
const client = new OpenAI({
apiKey: process.env.AVALAI_API_KEY,
baseURL: "https://api.avalai.ir/v1",
});
const response = await client.responses.create({
model: "gemini-4-argon",
input: "Review a database migration plan: identify failure modes and give a concise verification checklist.",
});
console.log(response.output_text);نرخ دلاری هر میلیون توکن تا پایان ۹ آذر ۱۴۰۵ (2026-11-30) برابر $2.00 ورودی، $0.10 ورودی از حافظه نهان و $10.00 خروجی است؛ نرخ استاندارد از ۱۰ آذر (2026-12-01) بهترتیب $4.00، $0.20 و $20.00 است. مجموع مصرف خروجی شامل استدلال را مقایسه کنید، نه فقط طول پاسخ قابل مشاهده. شناسه gemini-4-argon را صریح به کار ببرید؛ gemini-flash-latest همچنان به gemini-3.8-flash اشاره میکند.
راهنمای Google، نمونههای چهار قالب در خبر انتشار و قیمتگذاری را ببینید.
GPT-6.1 Sol
برای کدنویسی، تحلیل PDF و سند و کار حرفهای از gpt-6.1-sol با استدلال، ابزارها، خروجی ساختاریافته، بینایی و حافظه نهان پرامپت استفاده کنید. AvalAI از سطح ۱ در /v1/chat/completions، /v1/messages و /v1/responses پشتیبانی کامل دارد. سقفهای فهرست ۹۲۲٬۰۰۰ توکن ورودی و ۱۲۸٬۰۰۰ توکن خروجی هستند؛ جمع این سقفهای جداگانه را ظرفیت درخواست ندانید.
- تلاش: در شروع مقدار اضافی ارسال نکنید. Chat Completions از
reasoning_effortو Responses ازreasoning.effortاستفاده میکند. پیش از تنظیم هرکدام، مقدارهای پذیرفتهشده مسیر خود را بررسی کنید. فراداده محلیnoneوminimalرا پشتیبانینشده میداند؛ پیشفرض یا مجموعه مقدارهای مدلهای قدیمی GPT را تعمیم ندهید. - بودجه خروجی: استدلال توکن خروجی قابلصورتحساب مصرف میکند. برای استدلال و متن قابلمشاهده فضای کافی بگذارید؛ نتیجه، دلیل کوتاه، ارجاع یا گامهای راستیآزمایی بخواهید، نه زنجیره تفکر پنهان.
- چرخه ابزار: نوبتهای کامل دستیار و ابزار را حفظ کنید. رفتار ابزارهای میزبانیشده و وضعیت ذخیرهشده را مستقل آزمایش کنید؛ پشتیبانی کامل نقطه پایانی تأیید همه قابلیتهای ارائهدهنده نیست.
- هزینه: تا ۲۷۲ هزار توکن ورودی، شامل خود این مقدار، نرخ دلاری هر میلیون توکن $2.00 ورودی، $0.10 ورودی کششده، $2.50 ایجاد کش و $10.00 خروجی است. برای طول کل ورودی بیش از ۲۷۲ هزار توکن، نرخها بهترتیب $4.00، $0.20، $5.00 و $15.00 هستند؛ طول ورودی بازه خروجی را هم تعیین میکند.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["AVALAI_API_KEY"], base_url="https://api.avalai.ir/v1"
)
response = client.responses.create(
    model="gpt-6.1-sol",
    input="Review this release plan and give a concise verification checklist: deploy an API behind a feature flag.",
)
print(response.output_text)راهنمای OpenAI و اعلامیه انتشار را ببینید.
Claude Haiku 5.5
مدل claude-haiku-5-5 نخستین مدل خانواده Haiku از Anthropic با تلاش قابل تنظیم است. از آن برای خلاصهسازی، دستهبندی، پرسوجوهای کوتاه، پشتیبانی زنده و زیرعاملهای کدنویسی با دامنه مشخص استفاده کنید. Sonnet 5.5 و Opus 5.5 برای کدنویسی عاملی پیچیده و باز همچنان انتخابهای بهتری هستند. AvalAI از /v1/chat/completions، /v1/messages و /v1/responses پشتیبانی میکند.
- تنظیم تلاش: پس از بررسی مقادیر پذیرفتهشده در مسیر خود، از
output_config.effortبومی در Messages استفاده کنید. با درخواست مبنا و بدون تنظیم تلاش شروع کنید؛ سپس تلاش کمتر را برای کارهای کوتاه مقایسه کنید و تلاش بیشتر را فقط زمانی به کار ببرید که ارزیابیها بهبود کیفیت را نشان دهند. پیشفرضها، رفتار غیرفعالسازی تفکر یا بودجه ثابت تفکر Sonnet و Opus را به آن تعمیم ندهید. - بودجه خروجی: استدلال از توکنهای خروجی قابل محاسبه استفاده میکند و بودجه خروجی را با پاسخ نهایی به اشتراک میگذارد. فضای کافی بگذارید؛ نتیجه کوتاه یا راستیآزمایی بخواهید، نه زنجیره تفکر پنهان.
- مهاجرت و تاریخچه: توکنساز جدید ممکن است تعداد توکنها را نسبت به Haiku 4.5 کمی افزایش دهد. مصرف را دوباره اندازه بگیرید و نوبتهای کامل دستیار و ابزار، شامل بلوکهای تفکر بازگرداندهشده، را حفظ کنید. قابلیتهای ابزار، مرورگر میزبانیشده و Responses حالتمند را جداگانه بررسی کنید.
- قیمتگذاری: برای طول کل ورودی درخواست تا ۱۰۰ هزار توکن، شامل خود آستانه، نرخ هر میلیون توکن $0.10 ورودی، $0.01 ورودی از حافظه نهان، $0.20 ایجاد حافظه نهان و $0.50 خروجی است. بالاتر از 100K، نرخها $0.50/$0.05/$1.00/$2.50 هستند. این آستانه مربوط به قیمت است، نه سقف زمینه؛ محدودیتهای فعلی زمینه، خروجی و سطح حساب را در فهرست زنده بررسی کنید.
این مثال برای یک کار کوتاه، تلاش low را در Messages انتخاب میکند؛ پیشفرض همگانی AvalAI را تعیین نمیکند. اگر پشتیبانی از این تنظیم را بررسی نکردهاید، output_config را حذف کنید. آدرس پایه SDK شرکت Anthropic فقط باید نشانی میزبان باشد.
curl https://api.avalai.ir/v1/messages \
  -H "x-api-key: $AVALAI_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "claude-haiku-5-5",
    "max_tokens": 4096,
    "output_config": {"effort": "low"},
    "messages": [{"role": "user", "content": "Summarize this support ticket in one sentence: the customer was charged twice after retrying checkout."}]
}'import os
from anthropic import Anthropic
client = Anthropic(
api_key=os.environ["AVALAI_API_KEY"], base_url="https://api.avalai.ir"
)
response = client.messages.create(
model="claude-haiku-5-5",
max_tokens=4096,
output_config={"effort": "low"},
messages=[
{
"role": "user",
"content": "Summarize this support ticket in one sentence: the customer was charged twice after retrying checkout.",
}
],
)
for block in response.content:
if block.type == "text":
print(block.text)import Anthropic from "@anthropic-ai/sdk";
const client = new Anthropic({
apiKey: process.env.AVALAI_API_KEY,
baseURL: "https://api.avalai.ir",
});
const response = await client.messages.create({
model: "claude-haiku-5-5",
max_tokens: 4096,
output_config: { effort: "low" },
messages: [{ role: "user", content: "Summarize this support ticket in one sentence: the customer was charged twice after retrying checkout." }],
});
for (const block of response.content) {
if (block.type === "text") console.log(block.text);
}خبر انتشار، قیمتگذاری و راهنمای رسمی مهاجرت را ببینید. تنظیم reasoning.effort از OpenAI یا reasoning_effort در Chat Completions را بدون بررسی نگاشت مسیر انتخابی کپی نکنید.
Claude Sonnet 5.5
برای کدنویسی با دامنه مشخص، رفع اشکال، تهیه سند و کار مشارکتی از claude-sonnet-5-5 استفاده کنید. این مدل استدلال، بینایی، ورودی PDF، ابزارها، خروجی ساختاریافته و حافظه نهان پرامپت را با حداکثر ۱٬۰۰۰٬۰۰۰ توکن ورودی و ۱۲۸٬۰۰۰ توکن خروجی پشتیبانی میکند. دسترسی از سطح ۱ آغاز میشود. پشتیبانی /v1/chat/completions و /v1/messages کامل و /v1/responses جزئی است؛ برابری کامل ابزارهای میزبانیشده یا وضعیت ذخیرهشده تضمین نمیشود.
- تفکر تطبیقی و تلاش: در Messages از
thinking: {"type": "adaptive"}و کنترل پشتیبانیشدهoutput_config.effortاستفاده کنید. Anthropic برای Claude Platform مقدار پیشفرضhighو برای برنامههای Claude و Claude Code مقدارmediumرا مستند کرده است؛ اینها محصولات متفاوتاند، نه پیشفرض همگانی AvalAI. در صورت نیاز تلاش را صریح انتخاب کنید و نگاشت سازگاری Chat Completions را بررسی کنید. - مهاجرت از تفکر غیرفعال: گردشکارهای قدیمی با تفکر غیرفعال را به تنظیم جدید
between_toolsمنتقل کنید؛ این تنظیم تفکر ابتدای کار را غیرفعال نگه میدارد، نه همه استدلال را. راهنمای رسمی مهاجرت را دنبال کنید و پیش از جایگزینی بدنه درخواست، مسیر را بررسی کنید. مقدار ثابتbudget_tokensرا به درخواست تفکر تطبیقی کپی نکنید. - تفکر حفظشده: حفظ تفکر وابسته به حساب گسترش یافته است. بلوکهای امضاشده تفکر و تاریخچه کامل دستیار و ابزار را نگه دارید. انتقال گفتوگو میان حسابها ممکن است به مهاجرت نیاز داشته باشد؛ راهنمای حفظ تفکر را بررسی کنید.
- کنترلهای پشتیبانینشده:
temperature،top_p، پیشپرکردن پاسخ دستیار و اجبار به استفاده از ابزار را حذف کنید. برای استدلال و پاسخ نهایی فضای کافی در خروجی بگذارید. دلیل کوتاه یا راستیآزمایی بخواهید، نه زنجیره تفکر پنهان. - هزینه: نرخ دلاری AvalAI برای هر میلیون توکن $2.00 ورودی، $0.20 ورودی کششده، $4.00 ایجاد کش و $10.00 خروجی است. نرخ $4.00 ایجاد کش، قیمت بالادستی $2.50 نیست و زمان نگهداری حافظه نهان را تعیین نمیکند؛ بازه جداگانهای برای زمینه طولانی ثبت نشده است.
این مثال تلاش high را صریح انتخاب میکند؛ درخواست مهاجرت between_tools نیست. آدرس پایه Anthropic فقط باید نشانی میزبان باشد.
import os
from anthropic import Anthropic

client = Anthropic(
    api_key=os.environ["AVALAI_API_KEY"], base_url="https://api.avalai.ir"
)
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    thinking={"type": "adaptive"},
    output_config={"effort": "high"},
    messages=[
        {
            "role": "user",
            "content": "Review this release plan and give a concise verification checklist: deploy an API behind a feature flag.",
        }
    ],
)
for block in response.content:
    if block.type == "text":
print(block.text)راهنمای Anthropic و اعلامیه انتشار را ببینید.
Claude Opus 5.5
مدل claude-opus-5-5 از تفکر تطبیقی همیشهفعال استفاده میکند: تفکر غیرفعال نمیشود. تلاش پیشفرض ارائهدهنده medium است، برخلاف Fable 5.1 که high را به کار میبرد. با پیشفرض شروع کنید و پیش از افزایش تلاش، موفقیت وظیفه، تأخیر و هزینه کل توکنهای خروجی را مقایسه کنید. سطوح تلاش بومی low، medium، high، xhigh و max هستند؛ کنترلهای مسیر انتخابی را بررسی کنید و تنظیمات OpenAI یا Gemini را تعمیم ندهید.
در Chat Completions، تنظیمات اختصاصی ارائهدهنده را در extra_body قرار دهید. مقدار ثابت budget_tokens، تنظیم غیرفعالسازی تفکر، پیام دستیار از پیش تکمیلشده یا فیلدهای نمونهبرداری پشتیبانینشده مانند temperature و top_p را نفرستید.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["AVALAI_API_KEY"],
    base_url="https://api.avalai.ir/v1",
)

response = client.chat.completions.create(
    model="claude-opus-5-5",
    max_completion_tokens=8192,
    messages=[
        {
            "role": "user",
            "content": "Review a staged database migration and list verification and rollback checks.",
        }
    ],
    extra_body={
        "thinking": {"type": "adaptive"},
        "output_config": {"effort": "medium"},
    },
)

print(response.choices[0].message.content)- چرخههای ابزار: اجبار به استفاده از ابزار خطا ایجاد میکند؛ تنظیماتی را که فراخوانی را الزامی میکنند یا ابزار مشخصی را تحمیل میکنند، حذف کنید. آرگومانها را اعتبارسنجی کنید و برای اقدامهایی که وضعیت را تغییر میدهند، مرزهای تأیید را نگه دارید.
- یکپارچگی گفتوگو: بلوکهای تفکر به مدل و گفتوگو وابستهاند. محتوای کامل دستیار، امضاها و زمینه فراخوانی ابزار را حفظ کنید؛ بلوکهای تفکر را ویرایش یا به گفتوگوی دیگری منتقل نکنید. متنی که فقط برای نمایش فیلتر شده، قالب مناسبی برای ذخیره تاریخچه نیست.
- پیشرفت قابل مشاهده: متن میان ابزارها اکنون در بلوکهای تفکر میآید و با تنظیم پیشفرض نمایش خالی است. بازه بدون متن به معنی توقف درخواست نیست. از رویدادهای وضعیت ابزار استفاده کنید و پیش از نمایش متن پیشرفت، پشتیبانی کنترلهای نمایش را تأیید کنید.
- بودجه و قیمت: فهرست مدل سقف ورودی ۱٬۰۰۰٬۰۰۰ و حداکثر خروجی ۱۲۸٬۰۰۰ توکن را ثبت کرده است. استدلال بخشی از بودجه خروجی را مصرف میکند؛ برای پاسخ نهایی مفید هم فضا بگذارید. قیمت هر یک میلیون توکن به دلار آمریکا برابر ۴٫۰۰ برای ورودی، ۰٫۲۰ برای خواندن حافظه نهان، ۸٫۰۰ برای ایجاد حافظه نهان و ۲۰٫۰۰ برای خروجی است.
- نقاط پایانی: Chat Completions، Messages و Responses برای حسابهای سطح ۱ و بالاتر پشتیبانی کامل دارند. خبر انتشار نمونه ساده هر سه را ارائه میکند. ابزارهای میزبانیشده و قابلیتهای Fast mode یا Batch سرویس اصلی به پشتیبانی جداگانه مسیر نیاز دارند.
نتیجه، استناد به منابع و شواهد راستیآزمایی بخواهید، نه زنجیره فکر پنهان. مستندات حفظ تفکر و نکات مهاجرت، از جمله تغییر الزام ابزار استفاده از رایانه، را ببینید.
GPT-6 Sol، GPT-6 Luna و Grok 4.7
برای کدنویسی و استدلال حرفهای با بودجه محدود، gpt-6-sol؛ برای کار پرترافیک با هزینه کمتر، gpt-6-luna؛ و برای عاملهای مهندسی طولانیمدت و راستیآزمایی، grok-4.7 از xAI را انتخاب کنید. OpenAI از بهبود دقت اطلاعات، کدنویسی، کار با رایانه و همکاری نسبت به مدلهای متناظر GPT-5.6 خبر میدهد؛ xAI نیز از بهبود راستیآزمایی و مدیریت زمینه بلند نسبت به Grok 4.6 میگوید. این ادعاهای ارائهدهندگان را با وظایف واقعی خود بسنجید.
| مدل | حداکثر توکن ورودی | حداکثر توکن خروجی | پشتیبانی کامل نقاط پایانی | پشتیبانی جزئی نقاط پایانی |
|---|---|---|---|---|
gpt-6-sol | 922,000 | 128,000 | v1/chat/completions، v1/messages، v1/responses | — |
gpt-6-luna | 922,000 | 128,000 | v1/chat/completions، v1/messages، v1/responses | — |
grok-4.7 | 500,000 | 500,000 | v1/chat/completions، v1/messages | v1/responses |
اینها سقفهای جداگانه ورودی و خروجی در AvalAI هستند و استفاده همزمان از هر دو سقف را تضمین نمیکنند. در بودجه خروجی، علاوه بر پاسخ قابل مشاهده، برای استدلال پنهان نیز جا بگذارید. هر سه مدل تصویر ورودی را درک میکنند، اما مدل تولید مستقیم تصویر نیستند.
کنترل استدلال و سازگاری
- برای Sol و Luna، فقط با مقدارهای تأییدشده مسیر از
reasoning_effortدر Chat Completions یاreasoning.effortدر Responses استفاده کنید. برای مقایسه اولیه، این تنظیمات را ارسال نکنید؛ پیشفرضها را از برچسبهای ارزیابی ارائهدهنده نتیجه نگیرید. - منبع معرفی Grok 4.7 مقدارهای مجاز یا پیشفرض
reasoning_effortدر AvalAI را مشخص نمیکند. تا زمان تأیید، این پارامتر را حذف کنید؛ قابلیت استدلال به معنی پشتیبانی از همه کنترلهای مدلهای دیگر Grok نیست. - پشتیبانی جزئی Responses در Grok 4.7 به معنی برابری کامل ابزارهای میزبانیشده یا گردشکارهای دارای وضعیت ذخیرهشده نیست. پیش از تغییر نقطه پایانی، رفتوبرگشت ابزارها، خروجی دارای نوع مشخص و ادامه مکالمه را آزمایش کنید.
- پیشوندهای قابل استفاده مجدد پرامپت را حفظ کنید و استفاده واقعی از حافظه نهان را بسنجید. بهبودهای کش در سرویس اصلی OpenAI بهخودیخود همه فیلدهای تازه کنترل کش را در AvalAI تأیید نمیکنند.
- نتیجه کوتاه، شواهد و چکلیست راستیآزمایی بخواهید، نه زنجیره فکر پنهان. اجرای ابزارها و مجوز دسترسی را در اختیار برنامه نگه دارید.
برای Sol یا Luna با یک درخواست ساده Responses شروع کنید:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["AVALAI_API_KEY"],
    base_url="https://api.avalai.ir/v1",
)

response = client.responses.create(
    model="gpt-6-sol",
    input="Compare two database migration strategies and give a concise recommendation with validation checks.",
)

print(response.output_text)برای گزینه کمهزینهتر، مدل را به gpt-6-luna تغییر دهید. برای Grok 4.7 با Chat Completions شروع کنید:
curl https://api.avalai.ir/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $AVALAI_API_KEY" \
  -d '{
    "model": "grok-4.7",
    "messages": [
      {"role": "user", "content": "Compare two database migration strategies and give a concise recommendation with validation checks."}
    ]
}'تعرفه زمینه بلند برای Sol و Luna با ورودی بیش از ۲۷۲ هزار توکن و برای Grok 4.7 با ورودی بیش از ۲۰۰ هزار توکن اعمال میشود و تعرفه خروجی را نیز تغییر میدهد. ایجاد کش در Sol و Luna قیمت جداگانه دارد. برای برآورد هزینه و برنامهریزی مهاجرت، جدولهای کامل قیمت و نمونههای انتشار، راهنمای OpenAI و راهنمای xAI را ببینید.
شروع سریع با DeepSeek V4.1 Flash و Grok 4.6
هر دو مدل deepseek-v4.1-flash و grok-4.6 از v1/chat/completions و v1/messages پشتیبانی میکنند و پشتیبانی v1/responses برای آنها جزئی است. این به معنی برابری کامل ابزارهای داخلی Responses یا گردشکارهای دارای وضعیت ذخیرهشده نیست. پیش از تغییر نقطه پایانی، گردشکار دقیق خود، از جمله نتایج ابزارها و ادامه مکالمه را آزمایش کنید. ابتدا پارامتر تلاش استدلالی را ارسال نکنید؛ منابع ارائهشده مقدارهای مجاز آن در AvalAI را برای هیچیک از این دو مدل مشخص نمیکنند.
درخواست DeepSeek زیر پس از ارتقای خودکار به DeepSeek-V4.1-Flash-1017 همچنان از deepseek-v4.1-flash استفاده میکند. درخواستهای موجود با deepseek-flash نیز میتوانند همان شناسه را نگه دارند؛ نیازی به تغییر کد کلاینت نیست و قیمتها تغییری ندارند. نام مدل پایه 1017 جایگزین شناسه API نیست و این ارتقا پشتیبانی نقاط پایانی را گسترش نمیدهد.
curl https://api.avalai.ir/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $AVALAI_API_KEY" \
  -d '{
    "model": "deepseek-v4.1-flash",
    "messages": [
      {"role": "user", "content": "Compare two database migration strategies and give a concise recommendation with validation checks."}
    ]
}'برای ارزیابی همان وظیفه، مدل را به grok-4.6 تغییر دهید. هزینه DeepSeek V4.1 Flash به دلار آمریکا برای هر ۱ میلیون توکن برابر $0.15 ورودی، $0.003 ورودی ذخیرهشده و $0.60 خروجی است. در AvalAI همیشه تعرفه ثابت کمبار اعمال میشود؛ نیازی به زمانبندی نیست و دو برابر شدن یا نصف کردن دوباره قیمتها مطرح نیست. تعرفه Grok 4.6 تا سقف ۲۰۰ هزار توکن ورودی برابر $2.00 ورودی، $0.50 ورودی ذخیرهشده و $6.00 خروجی است؛ بالاتر از این مرز، تعرفهها بهترتیب $4.00، $1.00 و $12.50 به دلار آمریکا برای هر ۱ میلیون توکن هستند.
راهنمای DeepSeek، راهنمای xAI، ارتقای فعلی Flash و اطلاعیه جداگانه انتشار شهریور و مسیریابی V4-Pro را ببینید.
شروع کار با استدلال
برای مدلهای استدلالی OpenAI که از طریق AvalAI در دسترس هستند، وقتی مدل پشتیبانی میکند از /v1/responses استفاده کنید. Responses آیتمهای خروجی تایپشده را حفظ میکند، از reasoning.effort پشتیبانی میکند و میتواند آیتمهای reasoning مرتبط را در فراخوانیهای ابزار با previous_response_id یا replay کردن آیتمهای خروجی قبلی نگه دارد. مثالهای Chat Completions را برای routeهای ارائهدهندهمحور یا ادغامهای legacy که هنوز Responses ندارند نگه دارید.
چکلیست استدلال Responses-first
- برای کارهایی که به بیشترین توانایی نیاز دارند، از
gpt-6-astraباreasoning: {"effort": "medium"}استفاده کنید و فقط هنگامی تلاش را بهhighافزایش دهید که ارزیابیها هزینه و تأخیر بیشتر را توجیه کنند. برای استدلال GPT-6 با بودجه محدود،gpt-6-solو برای کار پرترافیک با هزینه کمتر،gpt-6-lunaرا ارزیابی کنید؛ پیش از مهاجرت از مدل قبلی، کنترلهای تلاش استدلالی و سقف ورودی ۹۲۲٬۰۰۰ توکنی آنها را بررسی کنید. - برای
max_output_tokensفضای کافی برای خروجی قابل مشاهده و توکنهای reasoning پنهان رزرو کنید. اگر پاسخ باstatus: "incomplete"وincomplete_details.reason: "max_output_tokens"برگشت، ممکن است مدل تمام بودجه را صرف reasoning کرده و هیچ متن قابل مشاهدهای تولید نکرده باشد. بودجه را افزایش دهید، در صورت پشتیبانیreasoning.effortرا رویlowیاnoneبگذارید یا task را سادهتر کنید. - وقتی مدل reasoning ابزار فراخوانی میکند، اگر سیاست نگهداری داده شما اجازه میدهد
store: trueرا تنظیم کنید، سپس آیتمهای reasoning و function-call پاسخ قبلی را برگردانید یا باprevious_response_idادامه دهید. - برای جریانهای stateless یا شبیه zero-retention، در صورت پشتیبانی
reasoning.encrypted_contentرا include کنید تا آیتمهای reasoning رمزنگاریشده قابل round-trip باشند. reasoning.summaryرا فقط وقتی درخواست کنید که مدل و حساب انتخابی از خلاصهها پشتیبانی کنند؛ summary برای observability است، نه raw chain-of-thought.- مدلهای reasoning را با هدف، محدودیتها، ابزارهای موجود و معیار موفقیت prompt کنید. بهجای درخواست chain-of-thought پنهان، توضیح نهایی کوتاه یا checklist بخواهید.
تأخیر و پیشرفت قابل مشاهده
در taskهای سخت، افزایش reasoning.effort میتواند کیفیت پاسخ را بهتر کند، اما زمان رسیدن اولین توکن مفید را هم بالا میبرد. راهنمای reasoning در OpenAI پیشنهاد میکند وقتی به پیشرفت قابل مشاهده سریعتر نیاز دارید، از مدل یک preamble کوتاه بخواهید. در AvalAI این الگو برای ابزارهای developer، review assistantها و workflowهای agentic طولانی مفید است:
- پیش از تحلیل عمیق فقط یک جمله کوتاه وضعیت بخواهید، نه chain-of-thought پنهان.
- preamble را بهعنوان status text نمایش دهید؛ آن را پاسخ نهایی حساب نکنید.
- قرارداد پاسخ نهایی را صریح نگه دارید: تصمیم، شواهد، checklist، برنامه patch یا اقدام بعدی.
- اگر route از
phaseپشتیبانی میکند، هنگام replay کردن state مقدارهایphase: "commentary"برای preamble وphase: "final_answer"برای پاسخ نهایی را حفظ کنید.
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["AVALAI_API_KEY"],
base_url="https://api.avalai.ir/v1",
)
response = client.responses.create(
model="gpt-6-astra",
reasoning={"effort": "high"},
instructions=(
"برای کارهای دشوار، ابتدا یک جمله کوتاه از وضعیت پیشرفت بده. "
"chain-of-thought پنهان را آشکار نکن. در پایان، تصمیم، شواهد "
"و checklist راستیآزمایی را کوتاه ارائه کن."
),
input="این برنامه مهاجرت را از نظر ریسکهای production بررسی کن: ...",
)
print(response.output_text)import OpenAI from "openai";
const client = new OpenAI({
apiKey: process.env.AVALAI_API_KEY,
baseURL: "https://api.avalai.ir/v1",
});
const response = await client.responses.create({
model: "gpt-6-astra",
reasoning: { effort: "high" },
instructions:
"برای کارهای دشوار، ابتدا یک جمله کوتاه از وضعیت پیشرفت بده. chain-of-thought پنهان را آشکار نکن. در پایان، تصمیم، شواهد و checklist راستیآزمایی را کوتاه ارائه کن.",
input: "این برنامه مهاجرت را از نظر ریسکهای production بررسی کن: ...",
});
console.log(response.output_text);جریانهای طولانی ابزارمحور و phase
راهنمای فعلی Responses در OpenAI توصیه میکند برای جریانهای طولانی یا ابزارمحور GPT-5.5/GPT-5.4 مقدار phase پیام دستیار را حفظ کنید. در AvalAI این قابلیت را وابسته به مدل و route بدانید: وقتی نگهداری state مجاز است previous_response_id را ترجیح دهید، و اگر تاریخچه دستیار را دستی replay میکنید، مقدارهای اصلی phase را بدون تغییر نگه دارید.
برای بهروزرسانیهای میانی دستیار قبل از tool call از phase: "commentary" و برای پاسخ تکمیلشده از phase: "final_answer" استفاده کنید. به پیامهای کاربر phase اضافه نکنید. حذف phase metadata میتواند باعث شود یک یادداشت میانی در flow چندمرحلهای مثل پاسخ نهایی تفسیر شود.
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["AVALAI_API_KEY"],
base_url="https://api.avalai.ir/v1",
)
response = client.responses.create(
model="gpt-5.6-sol",
input=[
{
"role": "assistant",
"phase": "commentary",
"content": "ابتدا لاگها را بررسی میکنم و بعد راهحل پیشنهاد میدهم.",
},
{
"role": "assistant",
"phase": "final_answer",
"content": "علت اصلی: race در cache invalidation.",
},
{"role": "user", "content": "حالا یک برنامه اصلاح امن برای rollout بده."},
],
)
print(response.output_text)import OpenAI from "openai";
const client = new OpenAI({
apiKey: process.env.AVALAI_API_KEY,
baseURL: "https://api.avalai.ir/v1",
});
const response = await client.responses.create({
model: "gpt-5.6-sol",
input: [
{
role: "assistant",
phase: "commentary",
content: "ابتدا لاگها را بررسی میکنم و بعد راهحل پیشنهاد میدهم.",
},
{
role: "assistant",
phase: "final_answer",
content: "علت اصلی: race در cache invalidation.",
},
{ role: "user", content: "حالا یک برنامه اصلاح امن برای rollout بده." },
],
});
console.log(response.output_text);مثال: استفاده از یک مدل استدلالی
PROMPT='یک اسکریپت bash بنویسید که یک ماتریس را به صورت رشته با فرمت '\''[1,2],[3,4],[5,6]'\'' دریافت کرده و ترانهاده آن را با همان فرمت چاپ کند.'

curl https://api.avalai.ir/v1/responses \
  -H "Authorization: Bearer $AVALAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
 "model": "gpt-5.6-sol",
 "reasoning": {"effort": "medium"},
 "input": [
 {
 "role": "user",
 "content": "'"$PROMPT"'"
 }
 ]
}'import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["AVALAI_API_KEY"],
base_url="https://api.avalai.ir/v1",
)
prompt = """
یک اسکریپت bash بنویسید که یک ماتریس را به صورت رشته با فرمت
'[1,2],[3,4],[5,6]' دریافت کرده و ترانهاده آن را با همان فرمت چاپ کند.
"""
try:
response = client.responses.create(
model="gpt-5.6-sol",
reasoning={"effort": "medium"},
input=[{"role": "user", "content": prompt}],
)
print(response.output_text)
except Exception as e:
print(f"یک خطای API رخ داد: {e}")import OpenAI from "openai"; // از کتابخانه استاندارد OpenAI پیکربندی شده برای AvalAI استفاده کنید
import * as dotenv from "dotenv";
dotenv.config();
const client = new OpenAI({
apiKey: process.env.AVALAI_API_KEY,
baseURL: "https://api.avalai.ir/v1", // نقطه پایانی AvalAI
});
const prompt = `
یک اسکریپت bash بنویسید که یک ماتریس را به صورت رشته با فرمت
'[1,2],[3,4],[5,6]' دریافت کرده و ترانهاده آن را با همان فرمت چاپ کند.
`;
async function runReasoning() {
try {
const response = await client.responses.create({
model: "gpt-5.6-sol",
reasoning: { effort: "medium" },
input: [{ role: "user", content: prompt }],
});
console.log(response.output_text);
} catch (error) {
console.error("یک خطای API رخ داد:", error);
}
}
runReasoning();package main
import (
"bytes"
"encoding/json"
"fmt"
"io"
"net/http"
"os"
)
func main() {
prompt := `
یک اسکریپت bash بنویسید که یک ماتریس را به صورت رشته با فرمت
'[1,2],[3,4],[5,6]' دریافت کرده و ترانهاده آن را با همان فرمت چاپ کند.
`
payload := map[string]any{
"model": "gpt-5.6-luna",
"reasoning": map[string]string{"effort": "medium"},
"input": []map[string]string{
{
"role": "user",
"content": prompt,
},
},
}
body, err := json.Marshal(payload)
if err != nil {
panic(err)
}
req, err := http.NewRequest("POST", "https://api.avalai.ir/v1/responses", bytes.NewBuffer(body))
if err != nil {
panic(err)
}
req.Header.Set("Authorization", "Bearer "+os.Getenv("AVALAI_API_KEY"))
req.Header.Set("Content-Type", "application/json")
resp, err := http.DefaultClient.Do(req)
if err != nil {
fmt.Printf("خطای Responses API: %v\n", err)
return
}
defer resp.Body.Close()
responseBody, err := io.ReadAll(resp.Body)
if err != nil {
panic(err)
}
fmt.Println(string(responseBody))
}<?php
$apiKey = getenv('AVALAI_API_KEY');
$prompt = <<<PROMPT
یک اسکریپت bash بنویسید که یک ماتریس را به صورت رشته با فرمت
'[1,2],[3,4],[5,6]' دریافت کرده و ترانهاده آن را با همان فرمت چاپ کند.
PROMPT;
$payload = [
'model' => 'gpt-5.6-luna',
'reasoning' => ['effort' => 'medium'],
'input' => [
['role' => 'user', 'content' => $prompt],
],
];
$ch = curl_init('https://api.avalai.ir/v1/responses');
curl_setopt_array($ch, [
CURLOPT_RETURNTRANSFER => true,
CURLOPT_POST => true,
CURLOPT_HTTPHEADER => [
'Authorization: Bearer ' . $apiKey,
'Content-Type: application/json',
],
CURLOPT_POSTFIELDS => json_encode($payload),
]);
$response = curl_exec($ch);
curl_close($ch);
echo $response;
?>تلاش استدلالی (Reasoning Effort)
برخی از مدلهای استدلالی پارامترهایی مانند reasoning.effort را برای هدایت میزان استدلال داخلی انجام شده قبل از تولید پاسخ میپذیرند. مقادیر بالقوه شامل موارد زیر است:
none: در مدلهای پشتیبانیشده استدلال صریح را غیرفعال میکند و سرعت را ترجیح میدهد.minimal: وقتی مدل این مقدار را پشتیبانی کند، کوچکترین بودجه reasoning را استفاده میکند.low: سرعت و استفاده کمتر از توکن را ترجیح میدهد.medium(اغلب پیشفرض): تعادلی بین سرعت و کیفیت استدلال برقرار میکند.high: استدلال کاملتر را ترجیح میدهد، بالقوه با استفاده از توکنهای بیشتر و زمان طولانیتر.xhighیاmax: در مدلهای پشتیبانیشده، بیشترین میزان استدلال را برای سختترین وظایف کدنویسی، ریاضی و عاملی استفاده میکند.
برای پارامترهای پشتیبانی شده و اثرات آنها، با مستندات مدل مورد نظر در AvalAI مشورت کنید.
انتخاب effort در production
effort را یک پیچ تنظیم تأخیر/هزینه/کیفیت بدانید، نه اولین راهحل برای پرامپت ضعیف. با پایینترین مقداری شروع کنید که evalهای شما را پاس میکند، سپس فقط برای taskهایی آن را بالا ببرید که توکنهای reasoning اضافه، کیفیت قابل اندازهگیری ایجاد میکنند.
| workload | نقطه شروع پیشنهادی | دلیل |
|---|---|---|
| voice، classification، retrieval ساده | none یا low در صورت پشتیبانی | تأخیر اولین توکن و مصرف کمتر توکن را اولویت میدهد. |
| پشتیبانی مشتری، draft، برنامهریزی ابزار | low یا medium | برای strategy ابزار فضا میگذارد بدون اینکه بیشازحد هزینه کند. |
| کدنویسی، پژوهش، تحلیل spreadsheet/document | medium | با پیشفرض متعادل راهنمای فعلی OpenAI برای مدلهایی مانند gpt-5.5 همراستا است. |
| deep research، security review، debugging دشوار | high یا xhigh پس از eval | وقتی دقت از تأخیر و هزینه مهمتر است مفید است. |
پیشفرضها وابسته به مدل هستند. فرض نکنید medium در OpenAI، Anthropic، Gemini، DeepSeek، XAI یا ارائهدهندگان دیگر universal است؛ effort انتخابشده را در traceهای eval ثبت کنید و قبل از تغییر پیشفرض production، کیفیت، تأخیر، output_tokens و output_tokens_details.reasoning_tokens را مقایسه کنید.
نحوه عملکرد استدلال
مدلهای استدلالی علاوه بر توکنهای ورودی و خروجی استاندارد، از توکنهای استدلالی به صورت داخلی استفاده میکنند. این توکنها نمایانگر "فرایند فکری" مدل هستند - تجزیه پرامپت، کاوش رویکردها و برنامهریزی پاسخ. پس از این مرحله استدلال داخلی، مدل توکنهای خروجی قابل مشاهده نهایی را تولید میکند و معمولا توکنهای استدلالی را از حافظه زمینه خود برای نوبتهای بعدی حذف میکند.
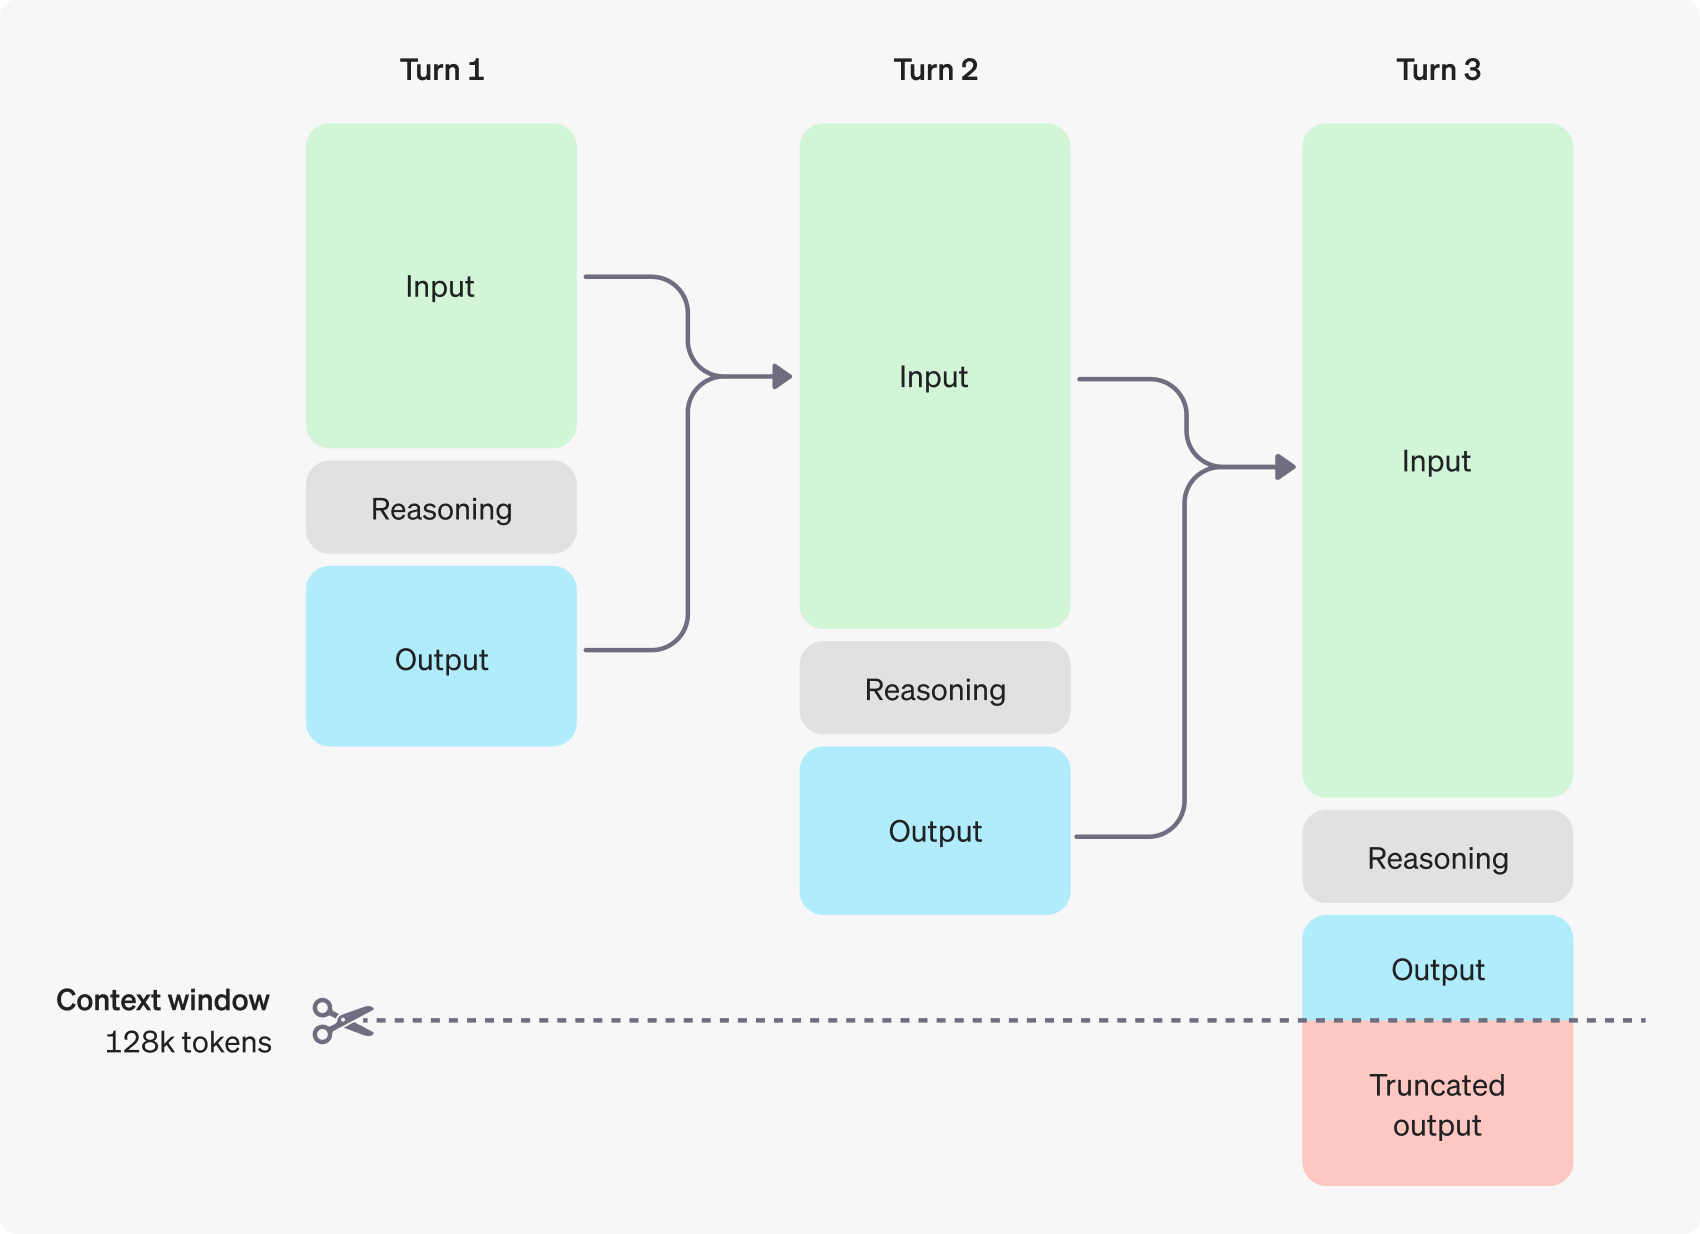 (منبع نمودار: OpenAI)
مهم: توکنهای reasoning ممکن است در متن نهایی پاسخ پنهان باشند، اما همچنان قابل پرداختاند و هنگام تولید در پنجره زمینه مدل فضا اشغال میکنند. در همه ارائهدهندگان و مدلها، این توکنها با نرخ توکن خروجی مدل انتخابی محاسبه میشوند. وقتی output_tokens از قبل آنها را شامل میشود، output_tokens_details.reasoning_tokens تفکیک این مقدار است؛ بنابراین افزودن reasoning_tokens به output_tokens باعث دوبارهشماری میشود. اگر route خروجی قابل مشاهده و reasoning را جدا گزارش میکند، همان نرخ توکن خروجی را برای هر دو مقدار به کار ببرید.
تنظیمات استدلال مختص ارائه دهنده
ارائهدهندگان مختلف مدل، قابلیتهای استدلالی را به روشهای خاص خود پیادهسازی میکنند. در اینجا نحوه استفاده از ویژگیهای استدلالی با هر ارائه دهنده از طریق AvalAI توضیح داده شده است:
تنظیمات استدلال مدلهای Gemini
مدلهای استدلالی جدید Gemini 3.8، 3.6، 3.5 و 3.1 از تفکر قابل تنظیم از طریق generationConfig.thinkingConfig مربوط به Gemini پشتیبانی میکنند. برای gemini-3.8-flash، gemini-flash-latest، gemini-3.6-flash، gemini-3.5-flash-lite، gemini-3.5-flash، gemini-3.1-pro-preview، gemini-3.1-flash-lite و gemini-3.1-flash-lite-preview از thinkingLevel برای تنظیم تعادل کیفیت، تأخیر و هزینه استفاده کنید. تلاش بیشتر در Gemini 3.8 Flash ممکن است توکن بیشتری برای استدلال و فراخوانی تکرارشونده ابزار مصرف کند؛ بنابراین کیفیت، تأخیر و مصرف توکن را در کنار یکدیگر ارزیابی کنید.
هنگام استفاده از کتابخانههای کلاینت OpenAI با AvalAI، تنظیمات اختصاصی Gemini را از طریق پارامتر extra_body ارسال کنید:
# مثال پایتون - سطوح تفکر Gemini
response = client.chat.completions.create(
model="gemini-3.8-flash",
messages=[
{
"role": "user",
"content": "این مسئله ریاضی پیچیده را حل کن. پاسخ نهایی، فرضهای کلیدی و یک checklist کوتاه برای راستیآزمایی برگردان: ...",
}
],
extra_body={"generationConfig": {"thinkingConfig": {"thinkingLevel": "high"}}},
)// مثال جاوااسکریپت - سطوح تفکر Gemini
const response = await client.chat.completions.create({
model: "gemini-3.8-flash",
messages: [
{
role: "user",
content: "این مسئله ریاضی پیچیده را حل کن. پاسخ نهایی، فرضهای کلیدی و یک checklist کوتاه برای راستیآزمایی برگردان: ...",
},
],
// @ts-expect-error extra_body برای گزینههای اختصاصی Gemini در AvalAI پشتیبانی میشود
extra_body: {
generationConfig: {
thinkingConfig: { thinkingLevel: "high" },
},
},
});نسخه معادل Responses API
Gemini 3.6 Flash و Gemini 3.5 Flash-Lite از /v1/responses بهصورت جزئی پشتیبانی میکنند. زمانی از این نسخه استفاده کنید که پارامترها و ابزارهای موردنیاز گردشکار شما پشتیبانی شوند؛ messages به input منتقل میشود و متن نهایی از response.output_text خوانده میشود.
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["AVALAI_API_KEY"],
base_url="https://api.avalai.ir/v1",
)
response = client.responses.create(
model="gemini-3.6-flash",
instructions="You are a helpful assistant.",
input="این مسئله ریاضی پیچیده را حل کن. پاسخ نهایی، فرضهای کلیدی و یک checklist کوتاه برای راستیآزمایی برگردان: ...",
)
print(response.output_text)import OpenAI from "openai";
const client = new OpenAI({
apiKey: process.env.AVALAI_API_KEY,
baseURL: "https://api.avalai.ir/v1",
});
const response = await client.responses.create({
model: "gemini-3.6-flash",
instructions: "You are a helpful assistant.",
input: "این مسئله ریاضی پیچیده را حل کن. پاسخ نهایی، فرضهای کلیدی و یک checklist کوتاه برای راستیآزمایی برگردان: ...",
});
console.log(response.output_text);curl https://api.avalai.ir/v1/responses \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $AVALAI_API_KEY" \
-d '
{
"model": "gemini-3.6-flash",
"input": "این مسئله ریاضی پیچیده را حل کن. پاسخ نهایی، فرضهای کلیدی و یک checklist کوتاه برای راستیآزمایی برگردان: ...",
"instructions": "You are a helpful assistant."
}'messages→input- پیام سیستمی →
instructionsیا آیتمdeveloper choices[0].message.content→response.output_text- برای ابزارها و خروجیهای چندوجهی،
response.outputرا بر اساسtypeبررسی کنید.
تنظیمات تفکر Gemini 3.6/3.5/3.1 شامل موارد زیر است:
thinkingLevel: عمق استدلال را کنترل میکند. سطحهای پشتیبانیشده به مدل و route انتخابی بستگی دارند.- سطح تفکر بالاتر معمولا کیفیت استدلال چندمرحلهای و استفاده از ابزار را بهتر میکند، اما میتواند تأخیر و مصرف توکن را افزایش دهد.
- برای پیشفرض production متعادل از یک سطح میانی پشتیبانیشده و برای کارهای پیچیده کدنویسی، عاملی یا تحلیلی از یک سطح بالاتر پشتیبانیشده استفاده کنید.
برای endpoint بومی Gemini v1beta، همین پیکربندی را مستقیما در بدنه درخواست ارسال کنید:
curl https://api.avalai.ir/v1beta/models/gemini-3.6-flash:generateContent \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $AVALAI_API_KEY" \
-d '{
"contents": [{"role": "user", "parts": [{"text": "برای مهاجرت مقاوم از monolith به microservices برنامهریزی کن."}]}],
"generationConfig": {
"thinkingConfig": {"thinkingLevel": "high"}
}
}'نکته قدیمی
thinking_budget مخصوص Gemini 2.5 Flash است. برای آخرین اطلاعات، به مستندات رسمی Google AI مراجعه کنید.
Gemini 2.5 Flash از کنترل تفکر مبتنی بر بودجه استفاده میکند:
# مثال پایتون - بودجه تفکر Gemini 2.5 Flash
response = client.chat.completions.create(
model="gemini-2.5-flash",
messages=[
{
"role": "user",
"content": "این مسئله ریاضی پیچیده را حل کن. پاسخ نهایی، فرضهای کلیدی و یک checklist کوتاه برای راستیآزمایی برگردان: ...",
}
],
extra_body={"thinking": {"type": "enabled", "budget_tokens": 2000}},
)// مثال جاوااسکریپت - بودجه تفکر Gemini 2.5 Flash
const responseAlt = await client.chat.completions.create({
model: "gemini-2.5-flash",
messages: [{ role: "user", content: "این مسئله ریاضی پیچیده را حل کن. پاسخ نهایی، فرضهای کلیدی و یک checklist کوتاه برای راستیآزمایی برگردان: ..." }],
// @ts-expect-error thinking یک پارامتر اختصاصی ارائهدهنده و مستندنشده است
thinking: { type: "enabled", budget_tokens: 2000 },
});نسخه معادل Responses API مدل این نسخه روی `gpt-5.5` تنظیم شده، چون `gemini-2.5-flash` ممکن است در دادههای فعلی AvalAI برای `/v1/responses` فعال نباشد.
وقتی مدل انتخابی از /v1/responses پشتیبانی میکند، این نسخه را کنار مثال Chat Completions استفاده کنید. messages به input منتقل میشود و متن نهایی از response.output_text خوانده میشود.
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["AVALAI_API_KEY"],
base_url="https://api.avalai.ir/v1",
)
response = client.responses.create(
model="gpt-5.6-sol",
instructions="You are a helpful assistant.",
input="این مسئله ریاضی پیچیده را حل کن. پاسخ نهایی، فرضهای کلیدی و یک checklist کوتاه برای راستیآزمایی برگردان: ...",
)
print(response.output_text)import OpenAI from "openai";
const client = new OpenAI({
apiKey: process.env.AVALAI_API_KEY,
baseURL: "https://api.avalai.ir/v1",
});
const response = await client.responses.create({
model: "gpt-5.6-sol",
instructions: "You are a helpful assistant.",
input: "این مسئله ریاضی پیچیده را حل کن. پاسخ نهایی، فرضهای کلیدی و یک checklist کوتاه برای راستیآزمایی برگردان: ...",
});
console.log(response.output_text);curl https://api.avalai.ir/v1/responses \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $AVALAI_API_KEY" \
-d '
{
"model": "gpt-5.6-sol",
"input": "این مسئله ریاضی پیچیده را حل کن. پاسخ نهایی، فرضهای کلیدی و یک checklist کوتاه برای راستیآزمایی برگردان: ...",
"instructions": "You are a helpful assistant."
}'messages→input- پیام سیستمی →
instructionsیا آیتمdeveloper choices[0].message.content→response.output_text- برای ابزارها و خروجیهای چندوجهی،
response.outputرا بر اساسtypeبررسی کنید.
با تنظیم سطح یا بودجه تفکر مناسب، میتوانید هم عمق استدلال و هم هزینه فراخوانیهای API خود را کنترل کنید.
تنظیمات استدلال مدلهای Anthropic
مدلهای Claude از Anthropic (بهویژه claude-haiku-5-5، claude-sonnet-5-5، claude-opus-5-5، claude-fable-5-1، claude-opus-5، claude-sonnet-5، claude-opus-4-8، claude-opus-4-7، claude-sonnet-4-6 و claude-haiku-4-5) از استدلال قابل تنظیم با تنظیمات تفکر اختصاصی ارائهدهنده پشتیبانی میکنند. کنترل تلاش و آستانه قیمت را در راهنمای Haiku 5.5 و الزامات مهاجرت را در راهنمای Sonnet 5.5 ببینید. برای Claude Opus 5.5، Claude Fable 5.1 و Claude Opus 5 از thinking: {"type": "adaptive"} همراه با output_config.effort استفاده کنید و بودجه ثابت تفکر گسترده نفرستید. تفکر در Claude Opus 5.5 و Claude Fable 5.1 همیشه فعال است. پیشفرض Opus 5.5 برابر medium است؛ برای محدودیتهای اجبار ابزار و تاریخچه گفتوگو، راهنمای اختصاصی آن را ببینید. تلاش را فقط زمانی افزایش دهید که ارزیابیها بهبود معنادار موفقیت وظیفه را نشان دهند.
response = client.chat.completions.create(
model="claude-fable-5-1",
messages=[
{
"role": "user",
"content": "این طراحی مهاجرت را تحلیل کن، حالتهای شکست را شناسایی کن و برنامه rollback را بررسی کن.",
}
],
extra_body={
"thinking": {"type": "adaptive"},
"output_config": {"effort": "high"},
},
)نسخه معادل Responses API؛ Claude Fable 5.1 در `/v1/responses` پشتیبانی جزئی دارد و باید فیلدها و ابزارهای موردنیاز را پیش از استفاده در محیط تولید بررسی کنید.
وقتی مدل انتخابی از /v1/responses پشتیبانی میکند، این نسخه را کنار مثال Chat Completions استفاده کنید. messages به input منتقل میشود و متن نهایی از response.output_text خوانده میشود.
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["AVALAI_API_KEY"],
base_url="https://api.avalai.ir/v1",
)
response = client.responses.create(
model="gpt-5.6-sol",
instructions="You are a helpful assistant.",
input="این طراحی مهاجرت را تحلیل کن، حالتهای شکست را شناسایی کن و برنامه rollback را بررسی کن.",
)
print(response.output_text)messages→input- پیام سیستمی →
instructionsیا آیتمdeveloper choices[0].message.content→response.output_text- برای ابزارها و خروجیهای چندوجهی،
response.outputرا بر اساسtypeبررسی کنید.
کنترلهای effort در Anthropic اختصاصی ارائهدهنده هستند؛ پارامترهای thinking مدلهای Gemini یا فیلد reasoning.effort مدلهای OpenAI را بدون بررسی route انتخابی کپی نکنید. بهجای chain-of-thought پنهان، دلیل کوتاه یا شواهد بررسی درخواست کنید.
تنظیمات استدلال مدلهای OpenAI
جدیدترین مدلهای استدلالی OpenAI (gpt-5.5، gpt-5.4-pro، gpt-5.4، gpt-5.4-mini، gpt-5.4-nano، gpt-5.3-codex، gpt-5-pro، o4-mini، o3 و o3-mini) دارای قابلیتهای استدلالی داخلی هستند که در صورت نیاز به طور خودکار فعال میشوند. برای این مدلها، ممکن است توکنهای استدلالی را در آمار استفاده خود مشاهده کنید، اما فرآیند استدلال بیشتر در عملکرد مدل یکپارچه شده است.
برای کنترل پیشرفتهتر، برخی نقاط پایانی ممکن است از پارامترهایی مانند reasoning.effort برای هدایت میزان استدلال داخلی پشتیبانی کنند:
response = client.chat.completions.create(
model="gpt-5.6-sol",
messages=[
{
"role": "user",
"content": "یک الگوریتم برای حل این مسئله بهینهسازی طراحی کن: ...",
}
],
extra_body={"reasoning": {"effort": "high"}}, # درخواست استدلال کاملتر
)نسخه معادل Responses API
وقتی مدل انتخابی از /v1/responses پشتیبانی میکند، این نسخه را کنار مثال Chat Completions استفاده کنید. messages به input منتقل میشود و متن نهایی از response.output_text خوانده میشود.
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["AVALAI_API_KEY"],
base_url="https://api.avalai.ir/v1",
)
response = client.responses.create(
model="gpt-5.6-sol",
instructions="You are a helpful assistant.",
input="یک الگوریتم برای حل این مسئله بهینهسازی طراحی کن: ...",
)
print(response.output_text)messages→input- پیام سیستمی →
instructionsیا آیتمdeveloper choices[0].message.content→response.output_text- برای ابزارها و خروجیهای چندوجهی،
response.outputرا بر اساسtypeبررسی کنید.
تنظیمات استدلال مدلهای DeepSeek
برای یکپارچهسازیهای جدید، از deepseek-v4.1-flash و بخش شروع سریع بالا استفاده کنید؛ درخواستهای موجود با deepseek-flash میتوانند همان شناسه را نگه دارند. هر دو اکنون بدون تغییر کد کلاینت یا قیمت از DeepSeek-V4.1-Flash-1017 استفاده میکنند. ارتقای مدل پایه مقدار تازهای برای تلاش تعیین نمیکند و تنظیمات تاریخی زیر را بهروز نمیکند. AvalAI نامهای deepseek-reasoner و deepseek-chat را طبق سیاست سازگاری ۱۴۰۵-۰۵-۲۳ / (2026-08-14) حفظ میکند و بازنشستگی سرویس مستقیم در ۱۴۰۵-۰۵-۰۲ / (2026-07-24) را بر آنها اعمال نمیکند. اطلاعیه جداگانه V4-Pro، هدایت به V4.1 Flash و اعمال تعرفه آن را از ۱۴۰۵-۰۶-۲۳ / (2026-09-14) ساعت 04:00 UTC تعیین کرده بود؛ آن را بخشی از ارتقای مدل پایه این دو شناسه ندانید.
تنظیمات تاریخی V4: تنظیمات و مثالهای زیر رفتار V4-Flash-0731 و V4-Pro پیش از تغییر مسیر را ثبت میکنند؛ نه توصیه به انتخاب Pro هستند و نه مقدارهای مجاز تلاش استدلالی V4.1 Flash. مسیرهای تفکری پشتیبانیشده میتوانند فیلد اختصاصی ارائهدهنده، یعنی reasoning_content، را همراه پاسخ نهایی برگردانند؛ فیلدهای لازم برای گردشکار ابزار خود را حفظ کنید.
ویژگیهای کلیدی:
reasoning_content: حاوی trace استدلالی ارائهشده توسط provider برای تداوم فراخوانی ابزار و observabilitycontent: حاوی پاسخ نهایی- Trace استدلالی: از trace ارائهشده توسط provider برای debugging، تداوم فراخوانی ابزار و observability استفاده کنید
- ادغام با فراخوانی ابزار: حالت تفکری با فراخوانی تابع کار میکند
- کلید حالت تفکری: هرجا route انتخابی V4 این کلید را ارائه میدهد، از
extra_body={"thinking": {"type": "enabled"}}یا{"type": "disabled"}استفاده کنید - تلاش استدلالی: DeepSeek-V4-Flash-0731 از
reasoning_effort: "low"،"high"یا"max"پشتیبانی میکند؛ پیش از اشتراک پیکربندی میان خانواده، مقدارهای V4-Pro را جداگانه بررسی کنید - پنجره زمینه: مدلهای پرچمدار V4 بهصورت پیشفرض پنجره زمینه ۱ میلیون توکنی دارند
مثال تاریخی (حالت تفکری، V4-Pro پیش از تغییر مسیر):
response = client.chat.completions.create(
model="deepseek-v4-pro",
messages=[
{
"role": "user",
"content": "۹.۱۱ و ۹.۸، کدام بزرگتر است؟",
}
],
reasoning_effort="high",
extra_body={"thinking": {"type": "enabled"}},
)
# دسترسی به فرآیند استدلال
reasoning = response.choices[0].message.reasoning_content
# دسترسی به پاسخ نهایی
answer = response.choices[0].message.contentنسخه معادل Responses API مدل این نسخه روی `gpt-5.5` تنظیم شده، چون `deepseek-v4-pro` ممکن است در دادههای فعلی AvalAI برای `/v1/responses` فعال نباشد.
وقتی مدل انتخابی از /v1/responses پشتیبانی میکند، این نسخه را کنار مثال Chat Completions استفاده کنید. messages به input منتقل میشود و متن نهایی از response.output_text خوانده میشود.
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["AVALAI_API_KEY"],
base_url="https://api.avalai.ir/v1",
)
response = client.responses.create(
model="gpt-5.6-sol",
instructions="You are a helpful assistant.",
input="۹.۱۱ و ۹.۸، کدام بزرگتر است؟",
)
print(response.output_text)messages→input- پیام سیستمی →
instructionsیا آیتمdeveloper choices[0].message.content→response.output_text- برای ابزارها و خروجیهای چندوجهی،
response.outputرا بر اساسtypeبررسی کنید.
مثال تاریخی V4-Flash:
response = client.chat.completions.create(
model="deepseek-v4-flash",
messages=[
{
"role": "user",
"content": "تفاوتهای حالت تفکری و غیرتفکری را خلاصه کن.",
}
],
extra_body={"thinking": {"type": "enabled"}},
)نسخه معادل Responses API مدل این نسخه روی `gpt-5.5` تنظیم شده، چون `deepseek-v4-flash` ممکن است در دادههای فعلی AvalAI برای `/v1/responses` فعال نباشد.
وقتی مدل انتخابی از /v1/responses پشتیبانی میکند، این نسخه را کنار مثال Chat Completions استفاده کنید. messages به input منتقل میشود و متن نهایی از response.output_text خوانده میشود.
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["AVALAI_API_KEY"],
base_url="https://api.avalai.ir/v1",
)
response = client.responses.create(
model="gpt-5.6-sol",
instructions="You are a helpful assistant.",
input="تفاوتهای حالت تفکری و غیرتفکری را خلاصه کن.",
)
print(response.output_text)messages→input- پیام سیستمی →
instructionsیا آیتمdeveloper choices[0].message.content→response.output_text- برای ابزارها و خروجیهای چندوجهی،
response.outputرا بر اساسtypeبررسی کنید.
⚠️ حیاتی: فراخوانی ابزار در حالت تفکری
هنگام استفاده از فراخوانی ابزار با مدلهای DeepSeek V4 در حالت تفکری (شامل deepseek-v4-pro، deepseek-v4-flash با فعالسازی تفکری یا نام قدیمی deepseek-reasoner)، باید فیلد reasoning_content را در درخواستهای بعدی در همان نوبت به API بازگردانید. در غیر این صورت خطا دریافت میکنید:
Missing reasoning_content field in the assistant messageپیادهسازی صحیح فراخوانی ابزار:
# هنگام دریافت tool_calls از مدل، reasoning_content را در پیام دستیار درج کنید
assistant_message = {
    "role": "assistant",
    "content": message.content or "",
    "tool_calls": [...],
    "reasoning_content": message.reasoning_content,  # حیاتی: درج این فیلد الزامی است
}
messages.append(assistant_message)قوانین مکالمه چند نوبتی:
- در یک نوبت واحد (هنگام پردازش فراخوانی ابزار): همیشه
reasoning_contentرا درج کنید - بین نوبتها (پیام جدید کاربر): فقط
contentرا ارسال کنید، نهreasoning_content
برای مستندات کامل و مثالها به زبانهای مختلف، به مستندات مدلهای DeepSeek مراجعه کنید.
مرجع رسمی: DeepSeek Thinking Mode - Tool Calls
درخواستهای HTTP مستقیم
هنگام ارسال درخواستهای HTTP مستقیم یا استفاده از curl، میتوانید این پارامترها را مستقیما در بدنه درخواست قرار دهید:
curl https://api.avalai.ir/v1/chat/completions \
-H "Authorization: Bearer $AVALAI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-3.1-flash-lite-preview",
"messages": [{"role": "user", "content": "این مسئله ریاضی پیچیده را حل کن. پاسخ نهایی، فرضهای کلیدی و یک checklist کوتاه برای راستیآزمایی برگردان: ..."}],
"thinking": {"type": "enabled", "budget_tokens": 2000}
}'نسخه معادل Responses API مدل این نسخه روی `gpt-5.5` تنظیم شده، چون `gemini-3.1-flash-lite-preview` ممکن است در دادههای فعلی AvalAI برای `/v1/responses` فعال نباشد.
وقتی مدل انتخابی از /v1/responses پشتیبانی میکند، این نسخه را کنار مثال Chat Completions استفاده کنید. messages به input منتقل میشود و متن نهایی از response.output_text خوانده میشود.
curl https://api.avalai.ir/v1/responses \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $AVALAI_API_KEY" \
-d '
{
"model": "gpt-5.6-sol",
"input": "این مسئله ریاضی پیچیده را حل کن. پاسخ نهایی، فرضهای کلیدی و یک checklist کوتاه برای راستیآزمایی برگردان: ...",
"instructions": "You are a helpful assistant."
}'messages→input- پیام سیستمی →
instructionsیا آیتمdeveloper choices[0].message.content→response.output_text- برای ابزارها و خروجیهای چندوجهی،
response.outputرا بر اساسtypeبررسی کنید.
با تنظیم این پارامترها، میتوانید عمق استدلال را در برابر هزینه و سرعت برای مورد استفاده خاص خود در بین ارائهدهندگان مختلف مدل متعادل کنید.
مدیریت پنجره زمینه (Context Window)
اطمینان حاصل کنید که فضای کافی در پنجره زمینه برای هر دو خروجی مورد انتظار و توکنهای استدلال داخلی باقی مانده است. مسائل پیچیده ممکن است به هزاران یا حتی دهها هزار توکن استدلالی نیاز داشته باشند.
شما اغلب میتوانید تفکیک میزان استفاده از توکن (شامل توکنهای استدلالی، در صورت افشا شدن توسط API) را در شی usage پاسخ API پیدا کنید. در Responses شرکت OpenAI، مقدار output_tokens کل خروجی تولیدشده و شامل توکنهای reasoning است؛ مقدار reasoning_tokens در فیلد تودرتو عدد اضافهای برای جمع کردن نیست.
نمونه شی usage در OpenAI Responses:
{
  "usage": {
    "input_tokens": 75,
    "input_tokens_details": {
      "cached_tokens": 0
    },
    "output_tokens": 1186,
    "output_tokens_details": {
      "reasoning_tokens": 1024
    },
    "total_tokens": 1261
  }
}برای طول پنجره زمینه مدلهای خاص، مستندات مدلهای AvalAI را بررسی کنید.
از telemetry شیء usage بهعنوان چرخه تنظیم استفاده کنید:
- برای هر نمونه eval،
model، مقدارreasoning.effort، مقدارmax_output_tokens، تأخیر، وضعیت و مصرف توکن را log کنید. - اگر
reasoning_tokensزیاد است اما کیفیت پاسخ بهتر نمیشود، effort را پایین بیاورید یا پرامپت را سادهتر کنید. - اگر
status: "incomplete"یا خروجی قابل مشاهده ناقص دیدید،max_output_tokensرا افزایش دهید، task را تقسیم کنید یا زمینه بازیابیشده را کمتر کنید. - برای Chat Completions و Responses baseline جدا نگه دارید، چون Responses میتواند آیتمهای reasoning را در tool callها حفظ کند اما Chat Completions stateless است.
کنترل هزینهها
برای مدیریت هزینهها:
- به پارامتر
reasoning.effort(یا معادل آن) در صورت وجود توجه داشته باشید. تلاش بالاتر معمولا به معنای توکنهای بیشتر است. - از پارامتر
max_tokens(یا پارامتر معادل مانندmax_output_tokens) در درخواست API خود برای محدود کردن تعداد کل توکنهای تولید شده (استدلال + خروجی) استفاده کنید.
تخصیص فضا برای استدلال
در مدلهای دارای reasoning، پارامترهای max_output_tokens در Responses، max_completion_tokens در Chat Completions و پارامتر قدیمی max_tokens یک بودجه مشترک برای تولید هستند؛ هم توکنهای reasoning پنهان و هم توکنهای پاسخ قابل مشاهده میتوانند این بودجه را مصرف کنند. این پارامترها سهم جداگانهای برای پاسخ نهایی رزرو نمیکنند.
اگر reasoning تمام سقف را مصرف کند، ممکن است پاسخ فقط آیتم reasoning داشته باشد و هیچ متنی برنگرداند. این وضعیت معمولا ناشی از تمام شدن بودجه توکن است، نه لزوما content filter یا در دسترس نبودن مدل. نشانههای رایج عبارتاند از:
- Responses: مقدار
status: "incomplete"وincomplete_details.reason: "max_output_tokens". - Usage: مقدار
output_tokens_details.reasoning_tokensبه کلoutput_tokensنزدیک است، اما متن قابل مشاهده خالی یا وجود ندارد. - Chat Completions: مقدار
finish_reason: "length"، گاهی پیش از تولید محتوای قابل استفاده.
برای رفع مشکل، سقف خروجی مربوط را تا حداکثر پشتیبانیشده مدل افزایش دهید، در صورت پشتیبانی reasoning.effort را روی low یا none بگذارید، task را ساده یا به چند درخواست تقسیم کنید و برای پاسخ نهایی حاشیه امن مبتنی بر اندازهگیری در نظر بگیرید. سقف را فقط بر اساس طول متن قابل مشاهده مورد انتظار تعیین نکنید. مصرف توکن را به تفکیک مدل و نوع پرامپت ثبت کنید، زیرا نیاز reasoning حتی برای یک مدل ثابت نیز بین درخواستها تغییر میکند.
مدیریت پاسخهای ناقص (مثال)
کد شما باید نشانگرهایی را بررسی کند که تولید به دلیل محدودیت توکن متوقف شده است.
import json
# ... (راهاندازی کلاینت و درخواست اولیه مانند قبل) ...
try:
response = client.chat.completions.create(
model="gpt-5.6-sol",
messages=[{"role": "user", "content": prompt}],
max_tokens=300, # محدود کردن کل توکنهای تولید شده (استدلال + خروجی)
# در صورت لزوم، پارامترهای استدلال را اضافه کنید
)
finish_reason = response.choices[0].finish_reason
output_text = response.choices[0].message.content
if finish_reason == "length": # دلیل پایان استاندارد برای max_tokens
print("توکنها تمام شد (به max_tokens رسید).")
if output_text:
print("خروجی جزئی:", output_text)
else:
# این بدان معنی است که محدودیت در طول استدلال داخلی زده شد
print("توکنها در مرحله استدلال تمام شد.")
elif finish_reason == "stop":
print("با موفقیت تکمیل شد:")
print(output_text)
else:
print(f"با دلیل پایان یافت: {finish_reason}")
if output_text:
print("خروجی:", output_text)
except Exception as e:
print(f"یک خطای API رخ داد: {e}")// ... (راهاندازی کلاینت و درخواست اولیه مانند قبل) ...
async function runReasoningWithLimit() {
try {
const response = await client.chat.completions.create({
model: "gpt-5.6-sol",
messages: [{ role: "user", content: prompt }],
max_tokens: 300, // محدود کردن کل توکنهای تولید شده
// در صورت لزوم، پارامترهای استدلال را اضافه کنید
});
const finish_reason = response.choices[0].finish_reason;
const output_text = response.choices[0].message.content;
if (finish_reason === "length") {
// دلیل پایان استاندارد برای max_tokens
console.log("توکنها تمام شد (به max_tokens رسید).");
if (output_text) {
console.log("خروجی جزئی:", output_text);
} else {
console.log("توکنها در مرحله استدلال تمام شد.");
}
} else if (finish_reason === "stop") {
console.log("با موفقیت تکمیل شد:");
console.log(output_text);
} else {
console.log(`با دلیل پایان یافت: ${finish_reason}`);
if (output_text) {
console.log("خروجی:", output_text);
}
}
} catch (error) {
console.error("یک خطای API رخ داد:", error);
}
}
runReasoningWithLimit();package main
import (
"context"
"fmt"
"os"
openai "github.com/openai/openai-go"
)
func main() {
// ... (راهاندازی کلاینت مانند قبل) ...
prompt := "..." // پرامپت شما در اینجا
maxTokens := 300 // تعریف max_tokens
resp, err := client.CreateChatCompletion(
context.Background(),
openai.ChatCompletionRequest{
model: "gpt-5.6-luna",
Messages: []openai.ChatCompletionMessage{
{Role: openai.ChatMessageRoleUser, Content: prompt},
},
MaxTokens: maxTokens, // محدود کردن کل توکنهای تولید شده
// در صورت لزوم، پارامترهای استدلال را اضافه کنید
},
)
if err != nil {
fmt.Printf("خطای ChatCompletion: %v\n", err)
return
}
finishReason := resp.Choices[0].FinishReason
outputText := resp.Choices[0].Message.Content
if finishReason == openai.FinishReasonLength { // بررسی دلیل پایان length
fmt.Println("توکنها تمام شد (به max_tokens رسید).")
if outputText != "" {
fmt.Println("خروجی جزئی:", outputText)
} else {
fmt.Println("توکنها در مرحله استدلال تمام شد.")
}
} else if finishReason == openai.FinishReasonStop {
fmt.Println("با موفقیت تکمیل شد:")
fmt.Println(outputText)
} else {
fmt.Printf("با دلیل پایان یافت: %s\n", finishReason)
if outputText != "" {
fmt.Println("خروجی:", outputText)
}
}
}<?php
require 'vendor/autoload.php';
// ... (راهاندازی کلاینت مانند قبل) ...
$prompt = "..."; // پرامپت شما در اینجا
$maxTokens = 300; // تعریف max_tokens
try {
$response = $client->chat()->create([
'model' => 'gpt-5.6-luna',
'messages' => [
['role' => 'user', 'content' => $prompt],
],
'max_tokens' => $maxTokens, // محدود کردن کل توکنهای تولید شده
// در صورت لزوم، پارامترهای استدلال را اضافه کنید
]);
$finishReason = $response->choices[0]->finishReason;
// اطمینان حاصل کنید که محتوا قبل از دسترسی وجود دارد
$outputText = $response->choices[0]->message->content ?? null;
if ($finishReason === 'length') { // بررسی دلیل پایان length
echo "توکنها تمام شد (به max_tokens رسید).\n";
if ($outputText) {
echo "خروجی جزئی: " . $outputText . "\n";
} else {
echo "توکنها در مرحله استدلال تمام شد.\n";
}
} elseif ($finishReason === 'stop') {
echo "با موفقیت تکمیل شد:\n";
echo $outputText . "\n";
} else {
echo "Finished with reason: " . $finishReason . "\n";
if ($outputText) {
echo "Output: " . $outputText . "\n";
}
}
} catch (Exception $e) {
echo "یک خطای API رخ داد: " . $e->getMessage() . "\n";
}
?>نسخه معادل Responses API
وقتی مدل انتخابی از /v1/responses پشتیبانی میکند، این نسخه را کنار مثال Chat Completions استفاده کنید. Chat Completions پایان به دلیل کمبود توکن را با finish_reason: "length" نشان میدهد؛ Responses آن را با status: "incomplete" و incomplete_details.reason: "max_output_tokens" گزارش میکند.
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["AVALAI_API_KEY"],
base_url="https://api.avalai.ir/v1",
)
prompt = """
Write a bash script that takes a matrix represented as a string with
format '[1,2],[3,4],[5,6]' and prints the transpose in the same format.
"""
response = client.responses.create(
model="gpt-5.6-sol",
reasoning={"effort": "medium"},
input=[{"role": "user", "content": prompt}],
max_output_tokens=300,
)
if (
response.status == "incomplete"
and response.incomplete_details.reason == "max_output_tokens"
):
print("توکنها تمام شد.")
if response.output_text:
print("خروجی جزئی:", response.output_text)
else:
print("توکنها در مرحله reasoning تمام شد.")
else:
print(response.output_text)import OpenAI from "openai";
const client = new OpenAI({
apiKey: process.env.AVALAI_API_KEY,
baseURL: "https://api.avalai.ir/v1",
});
const prompt = `
Write a bash script that takes a matrix represented as a string with
format '[1,2],[3,4],[5,6]' and prints the transpose in the same format.
`;
const response = await client.responses.create({
model: "gpt-5.6-sol",
reasoning: { effort: "medium" },
input: [{ role: "user", content: prompt }],
max_output_tokens: 300,
});
if (
response.status === "incomplete" &&
response.incomplete_details?.reason === "max_output_tokens"
) {
console.log("توکنها تمام شد.");
if (response.output_text) {
console.log("خروجی جزئی:", response.output_text);
} else {
console.log("توکنها در مرحله reasoning تمام شد.");
}
} else {
console.log(response.output_text);
}PROMPT='Write a bash script that takes a matrix represented as a string with format "[1,2],[3,4],[5,6]" and prints the transpose in the same format.'
jq -n --arg prompt "$PROMPT" '{
model: "gpt-5.6-sol",
reasoning: {effort: "medium"},
input: [{role: "user", content: $prompt}],
max_output_tokens: 300
}' | curl https://api.avalai.ir/v1/responses \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $AVALAI_API_KEY" \
-d @- | jq '{
status,
incomplete_reason: .incomplete_details.reason,
output_text
}'messages→input- پیام سیستمی →
instructionsیا آیتمdeveloper max_tokens→max_output_tokenschoices[0].finish_reason == "length"→status == "incomplete"باincomplete_details.reasonchoices[0].message.content→response.output_text- برای ابزارها و خروجیهای چندوجهی،
response.outputرا بر اساسtypeبررسی کنید.
توصیه در مورد پرامپتنویسی
پرامپتنویسی برای مدلهای استدلالی میتواند کمی با پرامپتنویسی برای مدلهای استاندارد GPT متفاوت باشد.
- مدلهای استدلالی: اغلب با اهداف سطح بالا و مرحلههای میانی کمتر تجویزی، عملکرد خوبی دارند. آنها را مانند همکاران ارشدی در نظر بگیرید که میتوانید به آنها اعتماد کنید تا جزئیات را بفهمند.
- مدلهای GPT: اغلب از دستورالعملهای بسیار دقیق و تعاریف واضح فرمت خروجی مورد نظر بهره میبرند. آنها را مانند همکاران تازهکاری در نظر بگیرید که به راهنمایی صریح نیاز دارند.
ارائه هدف کلی و اجازه دادن به مدل استدلالی برای تعیین بهترین مسیر را در مقابل ارائه مراحل دقیق، آزمایش کنید.
مثالهای پرامپت
(توجه: مثالهای زیر از مدلهای دارای قابلیت استدلال مانند gpt-5.5، deepseek-v4.1-flash، qwen3.7-max و glm-5.3 استفاده میکنند. GLM-5.3 به thinking.type: "enabled" نیاز دارد و سطح استدلال low، high یا max را میپذیرد؛ این مقدارها قرارداد تلاش استدلالی DeepSeek V4.1 Flash نیستند. پارامترها و نقاط پایانی را در صورت نیاز بر اساس پیادهسازی AvalAI تنظیم کنید.)
۱. کدنویسی (بازسازی کد - Refactoring)
وظیفه: بازسازی یک کامپوننت React برای تغییر رنگ متن بر اساس دادهها.
// --- کد فراخوانی (Node.js) ---
import OpenAI from "openai";
import * as dotenv from "dotenv";
dotenv.config();
const client = new OpenAI({
apiKey: process.env.AVALAI_API_KEY,
baseURL: "https://api.avalai.ir/v1",
});
// توجه به تغییر: به جای بکتیک سهگانه در رشته پرامپت،
// از تورفتگی برای مثال کد داخلی استفاده کنید.
const prompt = `
دستورالعملها:
- با توجه به کامپوننت React زیر، آن را طوری تغییر دهید که کتابهای غیرداستانی متن قرمز داشته باشند.
- فقط کد بازسازی شده React را در پاسخ خود برگردانید.
- توضیحات یا بلوکهای کد مارکداون را شامل نکنید.
- از چهار فاصله برای تورفتگی استفاده کنید.
- طول خطوط را زیر ۸۰ ستون نگه دارید.
کد اصلی:
const books = [
{ title: 'تلماسه', category: 'fiction', id: 1 }, // داستانی
{ title: 'فرانکنشتاین', category: 'fiction', id: 2 }, // داستانی
{ title: 'مانیبال', category: 'nonfiction', id: 3 }, // غیرداستانی
];
export default function BookList() {
const listItems = books.map(book =>
<li>
{book.title}
</li>
);
return (
<ul>{listItems}</ul>
);
}
`.trim();
async function refactorCode() {
try {
const response = await client.chat.completions.create({
model: "gpt-5.6-sol", // از یک مدل استدلالی مناسب از AvalAI استفاده کنید
messages: [{ role: "user", content: prompt }],
temperature: 0.1, // دمای پایینتر برای خروجی کد قابل پیشبینیتر
});
console.log(response.choices[0].message.content);
} catch (error) {
console.error("خطای API:", error);
}
}
refactorCode();# --- کد فراخوانی (Python) ---
from openai import OpenAI
import os
client = OpenAI(
api_key=os.environ["AVALAI_API_KEY"],
base_url="https://api.avalai.ir/v1", # آدرس پایه
)
# توجه به تغییر: به جای بکتیک سهگانه در رشته پرامپت،
# از تورفتگی برای مثال کد داخلی استفاده کنید.
prompt = """
دستورالعملها:
- با توجه به کامپوننت React زیر، آن را طوری تغییر دهید که کتابهای غیرداستانی متن قرمز داشته باشند.
- فقط کد بازسازی شده React را در پاسخ خود برگردانید.
- توضیحات یا بلوکهای کد مارکداون را شامل نکنید.
- از چهار فاصله برای تورفتگی استفاده کنید.
- طول خطوط را زیر ۸۰ ستون نگه دارید.
کد اصلی:
const books = [
{ title: 'تلماسه', category: 'fiction', id: 1 }, // داستانی
{ title: 'فرانکنشتاین', category: 'fiction', id: 2 }, // داستانی
{ title: 'مانیبال', category: 'nonfiction', id: 3 }, // غیرداستانی
];
export default function BookList() {
const listItems = books.map(book =>
<li>
{book.title}
</li>
);
return (
<ul>{listItems}</ul>
);
}
""".strip()
try:
response = client.chat.completions.create(
model="gpt-5.6-sol", # از یک مدل استدلالی مناسب از AvalAI استفاده کنید
messages=[{"role": "user", "content": prompt}],
temperature=0.1, # دمای پایینتر برای خروجی کد قابل پیشبینیتر
)
print(response.choices[0].message.content)
except Exception as e:
print(f"خطای API: {e}")# --- کد فراخوانی (Bash/cURL) ---
# توجه به تغییر: به جای بکتیک سهگانه در رشته پرامپت،
# از تورفتگی برای مثال کد داخلی استفاده کنید.
PROMPT=$(
cat <<'EOF'
دستورالعملها:
- با توجه به کامپوننت React زیر، آن را طوری تغییر دهید که کتابهای غیرداستانی متن قرمز داشته باشند.
- فقط کد بازسازی شده React را در پاسخ خود برگردانید.
- توضیحات یا بلوکهای کد مارکداون را شامل نکنید.
- از چهار فاصله برای تورفتگی استفاده کنید.
- طول خطوط را زیر ۸۰ ستون نگه دارید.
کد اصلی:
const books = [
{ title: 'تلماسه', category: 'fiction', id: 1 }, // داستانی
{ title: 'فرانکنشتاین', category: 'fiction', id: 2 }, // داستانی
{ title: 'مانیبال', category: 'nonfiction', id: 3 }, // غیرداستانی
];
export default function BookList() {
const listItems = books.map(book =>
<li>
{book.title}
</li>
);
return (
<ul>{listItems}</ul>
);
}
EOF
)
# فرار از کاراکترهای خاص JSON در پرامپت
JSON_PROMPT=$(echo "$PROMPT" | jq -Rsa .)
curl https://api.avalai.ir/v1/chat/completions \
-H "Authorization: Bearer $AVALAI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-5.6-sol",
"messages": [{"role": "user", "content": '"$JSON_PROMPT"'}],
"temperature": 0.1
}'// --- کد فراخوانی (Go) ---
package main
import (
"context"
"fmt"
"os"
"strings"
openai "github.com/openai/openai-go"
)
func main() {
apiKey := os.Getenv("AVALAI_API_KEY")
baseURL := "https://api.avalai.ir/v1"
config := openai.DefaultConfig(apiKey)
config.BaseURL = baseURL
client := openai.NewClientWithConfig(config)
// توجه به تغییر: به جای بکتیک سهگانه در رشته پرامپت،
// از تورفتگی برای مثال کد داخلی استفاده کنید.
prompt := strings.TrimSpace(`
دستورالعملها:
- با توجه به کامپوننت React زیر، آن را طوری تغییر دهید که کتابهای غیرداستانی متن قرمز داشته باشند.
- فقط کد بازسازی شده React را در پاسخ خود برگردانید.
- توضیحات یا بلوکهای کد مارکداون را شامل نکنید.
- از چهار فاصله برای تورفتگی استفاده کنید.
- طول خطوط را زیر ۸۰ ستون نگه دارید.
کد اصلی:
const books = [
{ title: "تلماسه", category: "fiction", id: 1 }, // داستانی
{ title: "فرانکنشتاین", category: "fiction", id: 2 }, // داستانی
{ title: "مانیبال", category: "nonfiction", id: 3 }, // غیرداستانی
];
export default function BookList() {
const listItems = books.map(book =>
<li>
{book.title}
</li>
);
return (
<ul>{listItems}</ul>
);
}
`) // توجه: رشتههای فارسی در کد Go باید به درستی مدیریت شوند
temp := float32(0.1)
resp, err := client.CreateChatCompletion(
context.Background(),
openai.ChatCompletionRequest{
model: "gpt-5.6-luna", // از یک مدل استدلالی مناسب از AvalAI استفاده کنید
Messages: []openai.ChatCompletionMessage{
{Role: openai.ChatMessageRoleUser, Content: prompt},
},
Temperature: &temp,
},
)
if err != nil {
fmt.Printf("خطای API: %v\n", err)
return
}
fmt.Println(resp.Choices[0].Message.Content)
}// --- کد فراخوانی (PHP) ---
<?php
require 'vendor/autoload.php';
use OpenAI\Client;
$apiKey = getenv('AVALAI_API_KEY');
$baseURL = 'https://api.avalai.ir/v1';
// پیکربندی کلاینت (مثال)
$client = OpenAI::client($apiKey);
// تنظیم base URL در صورت نیاز از طریق factory/config
// توجه به تغییر: به جای بکتیک سهگانه در رشته پرامپت،
// از تورفتگی برای مثال کد داخلی استفاده کنید.
$prompt = trim(<<<PROMPT
دستورالعملها:
- با توجه به کامپوننت React زیر، آن را طوری تغییر دهید که کتابهای غیرداستانی متن قرمز داشته باشند.
- فقط کد بازسازی شده React را در پاسخ خود برگردانید.
- توضیحات یا بلوکهای کد مارکداون را شامل نکنید.
- از چهار فاصله برای تورفتگی استفاده کنید.
- طول خطوط را زیر ۸۰ ستون نگه دارید.
کد اصلی:
const books = [
{ title: 'تلماسه', category: 'fiction', id: 1 }, // داستانی
{ title: 'فرانکنشتاین', category: 'fiction', id: 2 }, // داستانی
{ title: 'مانیبال', category: 'nonfiction', id: 3 }, // غیرداستانی
];
export default function BookList() {
const listItems = books.map(book =>
<li>
{book.title}
</li>
);
return (
<ul>{listItems}</ul>
);
}
PROMPT);
try {
$response = $client->chat()->create([
'model' => 'gpt-5.6-luna', // از یک مدل استدلالی مناسب از AvalAI استفاده کنید
'messages' => [
['role' => 'user', 'content' => $prompt],
],
'temperature' => 0.1,
]);
echo $response->choices[0]->message->content;
} catch (Exception $e) {
echo "خطای API: " . $e->getMessage() . "\n";
}
?>نسخه معادل Responses API
وقتی مدل انتخابی از /v1/responses پشتیبانی میکند، این نسخه را کنار مثال Chat Completions استفاده کنید. همان task بازسازی کد را نگه میدارد، قوانین برنامه را به instructions منتقل میکند، و چون تغییر محدود و دقیق است از reasoning effort پایین استفاده میکند.
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["AVALAI_API_KEY"],
base_url="https://api.avalai.ir/v1",
)
prompt = """
با توجه به کامپوننت React زیر، آن را طوری تغییر دهید که کتابهای غیرداستانی متن قرمز داشته باشند.
فقط کد بازسازی شده React را در پاسخ خود برگردانید.
توضیحات یا بلوکهای کد مارکداون را شامل نکنید.
از چهار فاصله برای تورفتگی استفاده کنید.
طول خطوط را زیر ۸۰ ستون نگه دارید.
کد اصلی:
const books = [
{ title: 'تلماسه', category: 'fiction', id: 1 },
{ title: 'فرانکنشتاین', category: 'fiction', id: 2 },
{ title: 'مانیبال', category: 'nonfiction', id: 3 },
];
export default function BookList() {
const listItems = books.map(book =>
<li>
{book.title}
</li>
);
return (
<ul>{listItems}</ul>
);
}
"""
response = client.responses.create(
model="gpt-5.6-sol",
reasoning={"effort": "low"},
instructions=(
"Formatting re-enabled\n"
"You refactor code precisely. Return only the requested code."
),
input=prompt,
)
print(response.output_text)import OpenAI from "openai";
const client = new OpenAI({
apiKey: process.env.AVALAI_API_KEY,
baseURL: "https://api.avalai.ir/v1",
});
const prompt = `
با توجه به کامپوننت React زیر، آن را طوری تغییر دهید که کتابهای غیرداستانی متن قرمز داشته باشند.
فقط کد بازسازی شده React را در پاسخ خود برگردانید.
توضیحات یا بلوکهای کد مارکداون را شامل نکنید.
از چهار فاصله برای تورفتگی استفاده کنید.
طول خطوط را زیر ۸۰ ستون نگه دارید.
کد اصلی:
const books = [
{ title: 'تلماسه', category: 'fiction', id: 1 },
{ title: 'فرانکنشتاین', category: 'fiction', id: 2 },
{ title: 'مانیبال', category: 'nonfiction', id: 3 },
];
export default function BookList() {
const listItems = books.map(book =>
<li>
{book.title}
</li>
);
return (
<ul>{listItems}</ul>
);
}
`;
const response = await client.responses.create({
model: "gpt-5.6-sol",
reasoning: { effort: "low" },
instructions:
"Formatting re-enabled\nYou refactor code precisely. Return only the requested code.",
input: prompt,
});
console.log(response.output_text);PROMPT=$(
cat <<'EOF'
با توجه به کامپوننت React زیر، آن را طوری تغییر دهید که کتابهای غیرداستانی متن قرمز داشته باشند.
فقط کد بازسازی شده React را در پاسخ خود برگردانید.
توضیحات یا بلوکهای کد مارکداون را شامل نکنید.
از چهار فاصله برای تورفتگی استفاده کنید.
طول خطوط را زیر ۸۰ ستون نگه دارید.
کد اصلی:
const books = [
{ title: 'تلماسه', category: 'fiction', id: 1 },
{ title: 'فرانکنشتاین', category: 'fiction', id: 2 },
{ title: 'مانیبال', category: 'nonfiction', id: 3 },
];
export default function BookList() {
const listItems = books.map(book =>
<li>
{book.title}
</li>
);
return (
<ul>{listItems}</ul>
);
}
EOF
)
jq -n --arg prompt "$PROMPT" '{
model: "gpt-5.6-sol",
reasoning: {effort: "low"},
instructions: "Formatting re-enabled\nYou refactor code precisely. Return only the requested code.",
input: $prompt
}' | curl https://api.avalai.ir/v1/responses \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $AVALAI_API_KEY" \
-d @-messages→input- پیام سیستمی →
instructionsیا آیتمdeveloper choices[0].message.content→response.output_text- برای ابزارها و خروجیهای چندوجهی،
response.outputرا بر اساسtypeبررسی کنید.
۲. کدنویسی (برنامهریزی)
وظیفه: برنامهریزی و تولید کد برای یک برنامه پرسش و پاسخ ساده پایتون.
// --- کد فراخوانی (Node.js) ---
import OpenAI from "openai";
import * as dotenv from "dotenv";
dotenv.config();
const client = new OpenAI({
apiKey: process.env.AVALAI_API_KEY,
baseURL: "https://api.avalai.ir/v1",
});
const prompt = `
میخواهم یک برنامه پایتون بسازم که سوالات کاربر را دریافت کرده و آنها را
در یک ذخیرهساز ساده کلید-مقدار (مانند دیکشنری یا فایل JSON) که در آن
به پاسخها نگاشت شدهاند، جستجو کند. اگر یک تطابق نزدیک (بررسی بدون حساسیت به حروف بزرگ و کوچک) وجود داشته باشد،
پاسخ مطابق را بازیابی میکند. اگر وجود نداشته باشد، از کاربر میخواهد
پاسخی ارائه دهد و جفت سوال/پاسخ جدید را ذخیره میکند.
1. طرحی برای ساختار دایرکتوری (مثلا اسکریپت اصلی، فایل داده) ارائه دهید.
2. کد کامل پایتون برای اسکریپت اصلی را برگردانید.
3. یک ساختار JSON نمونه برای فایل داده برگردانید.
4. متن توضیحی را فقط در ابتدا و انتهای خروجی ارائه دهید، نه به صورت ترکیبی در کد یا خروجی ساختار فایل.
`.trim();
async function planProject() {
try {
const response = await client.chat.completions.create({
model: "deepseek-v4.1-flash", // از شناسه صریح V4.1 Flash استفاده کنید
messages: [{ role: "user", content: prompt }],
});
console.log(response.choices[0].message.content);
} catch (error) {
console.error("خطای API:", error);
}
}
planProject();# --- کد فراخوانی (Python) ---
from openai import OpenAI
import os
client = OpenAI(
api_key=os.environ["AVALAI_API_KEY"],
base_url="https://api.avalai.ir/v1", # آدرس پایه
)
prompt = """
میخواهم یک برنامه پایتون بسازم که سوالات کاربر را دریافت کرده و آنها را
در یک ذخیرهساز ساده کلید-مقدار (مانند دیکشنری یا فایل JSON) که در آن
به پاسخها نگاشت شدهاند، جستجو کند. اگر یک تطابق نزدیک (بررسی بدون حساسیت به حروف بزرگ و کوچک) وجود داشته باشد،
پاسخ مطابق را بازیابی میکند. اگر وجود نداشته باشد، از کاربر میخواهد
پاسخی ارائه دهد و جفت سوال/پاسخ جدید را ذخیره میکند.
1. طرحی برای ساختار دایرکتوری (مثلا اسکریپت اصلی، فایل داده) ارائه دهید.
2. کد کامل پایتون برای اسکریپت اصلی را برگردانید.
3. یک ساختار JSON نمونه برای فایل داده برگردانید.
4. متن توضیحی را فقط در ابتدا و انتهای خروجی ارائه دهید، نه به صورت ترکیبی در کد یا خروجی ساختار فایل.
""".strip()
try:
response = client.chat.completions.create(
model="deepseek-v4.1-flash", # از شناسه صریح V4.1 Flash استفاده کنید
messages=[{"role": "user", "content": prompt}],
)
print(response.choices[0].message.content)
except Exception as e:
print(f"خطای API: {e}")# --- کد فراخوانی (Bash/cURL) ---
PROMPT=$(
cat <<'EOF'
میخواهم یک برنامه پایتون بسازم که سوالات کاربر را دریافت کرده و آنها را
در یک ذخیرهساز ساده کلید-مقدار (مانند دیکشنری یا فایل JSON) که در آن
به پاسخها نگاشت شدهاند، جستجو کند. اگر یک تطابق نزدیک (بررسی بدون حساسیت به حروف بزرگ و کوچک) وجود داشته باشد،
پاسخ مطابق را بازیابی میکند. اگر وجود نداشته باشد، از کاربر میخواهد
پاسخی ارائه دهد و جفت سوال/پاسخ جدید را ذخیره میکند.
1. طرحی برای ساختار دایرکتوری (مثلا اسکریپت اصلی، فایل داده) ارائه دهید.
2. کد کامل پایتون برای اسکریپت اصلی را برگردانید.
3. یک ساختار JSON نمونه برای فایل داده برگردانید.
4. متن توضیحی را فقط در ابتدا و انتهای خروجی ارائه دهید، نه به صورت ترکیبی در کد یا خروجی ساختار فایل.
EOF
)
# فرار از کاراکترهای خاص JSON
JSON_PROMPT=$(echo "$PROMPT" | jq -Rsa .)
curl https://api.avalai.ir/v1/chat/completions \
-H "Authorization: Bearer $AVALAI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "deepseek-v4.1-flash",
"messages": [{"role": "user", "content": '"$JSON_PROMPT"'}]
}'// --- کد فراخوانی (Go) ---
package main
import (
"context"
"fmt"
"os"
"strings"
openai "github.com/openai/openai-go"
)
func main() {
apiKey := os.Getenv("AVALAI_API_KEY")
baseURL := "https://api.avalai.ir/v1"
config := openai.DefaultConfig(apiKey)
config.BaseURL = baseURL
client := openai.NewClientWithConfig(config)
prompt := strings.TrimSpace(`
میخواهم یک برنامه پایتون بسازم که سوالات کاربر را دریافت کرده و آنها را
در یک ذخیرهساز ساده کلید-مقدار (مانند دیکشنری یا فایل JSON) که در آن
به پاسخها نگاشت شدهاند، جستجو کند. اگر یک تطابق نزدیک (بررسی بدون حساسیت به حروف بزرگ و کوچک) وجود داشته باشد،
پاسخ مطابق را بازیابی میکند. اگر وجود نداشته باشد، از کاربر میخواهد
پاسخی ارائه دهد و جفت سوال/پاسخ جدید را ذخیره میکند.
1. طرحی برای ساختار دایرکتوری (مثلا اسکریپت اصلی، فایل داده) ارائه دهید.
2. کد کامل پایتون برای اسکریپت اصلی را برگردانید.
3. یک ساختار JSON نمونه برای فایل داده برگردانید.
4. متن توضیحی را فقط در ابتدا و انتهای خروجی ارائه دهید، نه به صورت ترکیبی در کد یا خروجی ساختار فایل.
`) // اطمینان از مدیریت صحیح UTF-8 در Go
resp, err := client.CreateChatCompletion(
context.Background(),
openai.ChatCompletionRequest{
Model: "deepseek-v4.1-flash", // از شناسه صریح V4.1 Flash استفاده کنید
Messages: []openai.ChatCompletionMessage{
{Role: openai.ChatMessageRoleUser, Content: prompt},
},
},
)
if err != nil {
fmt.Printf("خطای API: %v\n", err)
return
}
fmt.Println(resp.Choices[0].Message.Content)
}// --- کد فراخوانی (PHP) ---
<?php
require 'vendor/autoload.php';
use OpenAI\Client;
$apiKey = getenv('AVALAI_API_KEY');
$baseURL = 'https://api.avalai.ir/v1';
// پیکربندی کلاینت (مثال)
$client = OpenAI::client($apiKey);
// تنظیم base URL در صورت نیاز از طریق factory/config
$prompt = trim(<<<PROMPT
میخواهم یک برنامه پایتون بسازم که سوالات کاربر را دریافت کرده و آنها را
در یک ذخیرهساز ساده کلید-مقدار (مانند دیکشنری یا فایل JSON) که در آن
به پاسخها نگاشت شدهاند، جستجو کند. اگر یک تطابق نزدیک (بررسی بدون حساسیت به حروف بزرگ و کوچک) وجود داشته باشد،
پاسخ مطابق را بازیابی میکند. اگر وجود نداشته باشد، از کاربر میخواهد
پاسخی ارائه دهد و جفت سوال/پاسخ جدید را ذخیره میکند.
1. طرحی برای ساختار دایرکتوری (مثلا اسکریپت اصلی، فایل داده) ارائه دهید.
2. کد کامل پایتون برای اسکریپت اصلی را برگردانید.
3. یک ساختار JSON نمونه برای فایل داده برگردانید.
4. متن توضیحی را فقط در ابتدا و انتهای خروجی ارائه دهید، نه به صورت ترکیبی در کد یا خروجی ساختار فایل.
PROMPT);
try {
$response = $client->chat()->create([
'model' => 'deepseek-v4.1-flash', // از شناسه صریح V4.1 Flash استفاده کنید
'messages' => [
['role' => 'user', 'content' => $prompt],
],
]);
echo $response->choices[0]->message->content;
} catch (Exception $e) {
echo "خطای API: " . $e->getMessage() . "\n";
}
?>نمونه جایگزین با OpenAI Responses
این مثال برای همان کار برنامهریزی از gpt-5.6-sol و کنترلهای استدلالی خودش استفاده میکند. پشتیبانی Responses در deepseek-v4.1-flash جزئی است؛ تنظیمات تلاش این مدل را کپی نکنید و برابری کامل ابزارهای داخلی و گردشکارهای دارای وضعیت ذخیرهشده را فرض نکنید. پیش از تغییر نقطه پایانی، گردشکار دقیق خود را بررسی کنید.
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["AVALAI_API_KEY"],
base_url="https://api.avalai.ir/v1",
)
prompt = """
میخواهم یک برنامه پایتون بسازم که سوالات کاربر را دریافت کرده و آنها را
در یک ذخیرهساز ساده کلید-مقدار (مانند دیکشنری یا فایل JSON) که در آن
به پاسخها نگاشت شدهاند، جستجو کند. اگر یک تطابق نزدیک (بررسی بدون حساسیت به حروف بزرگ و کوچک) وجود داشته باشد،
پاسخ مطابق را بازیابی میکند. اگر وجود نداشته باشد، از کاربر میخواهد
پاسخی ارائه دهد و جفت سوال/پاسخ جدید را ذخیره میکند.
1. طرحی برای ساختار دایرکتوری (مثلا اسکریپت اصلی، فایل داده) ارائه دهید.
2. کد کامل پایتون برای اسکریپت اصلی را برگردانید.
3. یک ساختار JSON نمونه برای فایل داده برگردانید.
4. متن توضیحی را فقط در ابتدا و انتهای خروجی ارائه دهید، نه به صورت ترکیبی در کد یا خروجی ساختار فایل.
"""
response = client.responses.create(
model="gpt-5.6-sol",
reasoning={"effort": "medium"},
instructions=(
"Formatting re-enabled\n"
"You are a senior Python engineer. Follow the requested output contract exactly."
),
input=prompt,
)
print(response.output_text)import OpenAI from "openai";
const client = new OpenAI({
apiKey: process.env.AVALAI_API_KEY,
baseURL: "https://api.avalai.ir/v1",
});
const prompt = `
میخواهم یک برنامه پایتون بسازم که سوالات کاربر را دریافت کرده و آنها را
در یک ذخیرهساز ساده کلید-مقدار (مانند دیکشنری یا فایل JSON) که در آن
به پاسخها نگاشت شدهاند، جستجو کند. اگر یک تطابق نزدیک (بررسی بدون حساسیت به حروف بزرگ و کوچک) وجود داشته باشد،
پاسخ مطابق را بازیابی میکند. اگر وجود نداشته باشد، از کاربر میخواهد
پاسخی ارائه دهد و جفت سوال/پاسخ جدید را ذخیره میکند.
1. طرحی برای ساختار دایرکتوری (مثلا اسکریپت اصلی، فایل داده) ارائه دهید.
2. کد کامل پایتون برای اسکریپت اصلی را برگردانید.
3. یک ساختار JSON نمونه برای فایل داده برگردانید.
4. متن توضیحی را فقط در ابتدا و انتهای خروجی ارائه دهید، نه به صورت ترکیبی در کد یا خروجی ساختار فایل.
`;
const response = await client.responses.create({
model: "gpt-5.6-sol",
reasoning: { effort: "medium" },
instructions:
"Formatting re-enabled\nYou are a senior Python engineer. Follow the requested output contract exactly.",
input: prompt,
});
console.log(response.output_text);PROMPT=$(
cat <<'EOF'
میخواهم یک برنامه پایتون بسازم که سوالات کاربر را دریافت کرده و آنها را
در یک ذخیرهساز ساده کلید-مقدار (مانند دیکشنری یا فایل JSON) که در آن
به پاسخها نگاشت شدهاند، جستجو کند. اگر یک تطابق نزدیک (بررسی بدون حساسیت به حروف بزرگ و کوچک) وجود داشته باشد،
پاسخ مطابق را بازیابی میکند. اگر وجود نداشته باشد، از کاربر میخواهد
پاسخی ارائه دهد و جفت سوال/پاسخ جدید را ذخیره میکند.
1. طرحی برای ساختار دایرکتوری (مثلا اسکریپت اصلی، فایل داده) ارائه دهید.
2. کد کامل پایتون برای اسکریپت اصلی را برگردانید.
3. یک ساختار JSON نمونه برای فایل داده برگردانید.
4. متن توضیحی را فقط در ابتدا و انتهای خروجی ارائه دهید، نه به صورت ترکیبی در کد یا خروجی ساختار فایل.
EOF
)
jq -n --arg prompt "$PROMPT" '{
model: "gpt-5.6-sol",
reasoning: {effort: "medium"},
instructions: "Formatting re-enabled\nYou are a senior Python engineer. Follow the requested output contract exactly.",
input: $prompt
}' | curl https://api.avalai.ir/v1/responses \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $AVALAI_API_KEY" \
-d @-messages→input- پیام سیستمی →
instructionsیا آیتمdeveloper choices[0].message.content→response.output_text- برای ابزارها و خروجیهای چندوجهی،
response.outputرا بر اساسtypeبررسی کنید.
۳. تحقیقات علوم پایه، فناوری، مهندسی و ریاضیات (STEM)
وظیفه: پرسیدن در مورد ترکیبات بالقوه برای تحقیقات آنتیبیوتیکی.
// --- کد فراخوانی (Node.js) ---
import OpenAI from "openai";
import * as dotenv from "dotenv";
dotenv.config();
const client = new OpenAI({
apiKey: process.env.AVALAI_API_KEY,
baseURL: "https://api.avalai.ir/v1",
});
const prompt = `
سه ترکیب یا کلاس ترکیبی که باید برای پیشبرد تحقیقات در مورد
آنتیبیوتیکهای جدید، به ویژه علیه باکتریهای مقاوم، بیشتر بررسی کنیم، کدامند؟
به طور خلاصه توضیح دهید که چرا هر کدام امیدوارکننده است.
`.trim();
async function researchQuery() {
try {
const response = await client.chat.completions.create({
model: "gemini-3.1-pro-preview", // از یک مدل استدلالی مناسب از AvalAI استفاده کنید
messages: [{ role: "user", content: prompt }],
});
console.log(response.choices[0].message.content);
} catch (error) {
console.error("خطای API:", error);
}
}
researchQuery();# --- کد فراخوانی (Python) ---
from openai import OpenAI
import os
client = OpenAI(
api_key=os.environ["AVALAI_API_KEY"],
base_url="https://api.avalai.ir/v1", # آدرس پایه
)
prompt = """
سه ترکیب یا کلاس ترکیبی که باید برای پیشبرد تحقیقات در مورد
آنتیبیوتیکهای جدید، به ویژه علیه باکتریهای مقاوم، بیشتر بررسی کنیم، کدامند؟
به طور خلاصه توضیح دهید که چرا هر کدام امیدوارکننده است.
""".strip()
try:
response = client.chat.completions.create(
model="gemini-3.1-pro-preview", # از یک مدل استدلالی مناسب از AvalAI استفاده کنید
messages=[{"role": "user", "content": prompt}],
)
print(response.choices[0].message.content)
except Exception as e:
print(f"خطای API: {e}")# --- کد فراخوانی (Bash/cURL) ---
PROMPT=$(
cat <<'EOF'
سه ترکیب یا کلاس ترکیبی که باید برای پیشبرد تحقیقات در مورد
آنتیبیوتیکهای جدید، به ویژه علیه باکتریهای مقاوم، بیشتر بررسی کنیم، کدامند؟
به طور خلاصه توضیح دهید که چرا هر کدام امیدوارکننده است.
EOF
)
# فرار از کاراکترهای خاص JSON
JSON_PROMPT=$(echo "$PROMPT" | jq -Rsa .)
curl https://api.avalai.ir/v1/chat/completions \
-H "Authorization: Bearer $AVALAI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-3.1-pro-preview",
"messages": [{"role": "user", "content": '"$JSON_PROMPT"'}]
}'// --- کد فراخوانی (Go) ---
package main
import (
"context"
"fmt"
"os"
"strings"
openai "github.com/openai/openai-go"
)
func main() {
apiKey := os.Getenv("AVALAI_API_KEY")
baseURL := "https://api.avalai.ir/v1"
config := openai.DefaultConfig(apiKey)
config.BaseURL = baseURL
client := openai.NewClientWithConfig(config)
prompt := strings.TrimSpace(`
سه ترکیب یا کلاس ترکیبی که باید برای پیشبرد تحقیقات در مورد
آنتیبیوتیکهای جدید، به ویژه علیه باکتریهای مقاوم، بیشتر بررسی کنیم، کدامند؟
به طور خلاصه توضیح دهید که چرا هر کدام امیدوارکننده است.
`) // اطمینان از مدیریت صحیح UTF-8
resp, err := client.CreateChatCompletion(
context.Background(),
openai.ChatCompletionRequest{
Model: "gemini-3.1-pro-preview", // از یک مدل استدلالی مناسب از AvalAI استفاده کنید
Messages: []openai.ChatCompletionMessage{
{Role: openai.ChatMessageRoleUser, Content: prompt},
},
},
)
if err != nil {
fmt.Printf("خطای API: %v\n", err)
return
}
fmt.Println(resp.Choices[0].Message.Content)
}// --- کد فراخوانی (PHP) ---
<?php
require 'vendor/autoload.php';
use OpenAI\Client;
$apiKey = getenv('AVALAI_API_KEY');
$baseURL = 'https://api.avalai.ir/v1';
// پیکربندی کلاینت (مثال)
$client = OpenAI::client($apiKey);
// تنظیم base URL در صورت نیاز از طریق factory/config
$prompt = trim(<<<PROMPT
سه ترکیب یا کلاس ترکیبی که باید برای پیشبرد تحقیقات در مورد
آنتیبیوتیکهای جدید، به ویژه علیه باکتریهای مقاوم، بیشتر بررسی کنیم، کدامند؟
به طور خلاصه توضیح دهید که چرا هر کدام امیدوارکننده است.
PROMPT);
try {
$response = $client->chat()->create([
'model' => 'gemini-3.1-pro-preview', // از یک مدل استدلالی مناسب از AvalAI استفاده کنید
'messages' => [
['role' => 'user', 'content' => $prompt],
],
]);
echo $response->choices[0]->message->content;
} catch (Exception $e) {
echo "خطای API: " . $e->getMessage() . "\n";
}
?>نسخه معادل Responses API مدل این نسخه روی `gpt-5.5` تنظیم شده، چون `gemini-3.1-pro-preview` ممکن است در دادههای فعلی AvalAI برای `/v1/responses` فعال نباشد.
وقتی مدل انتخابی از /v1/responses پشتیبانی میکند، این نسخه را کنار مثال Chat Completions استفاده کنید. همان prompt پژوهشی را نگه میدارد، اما یک مرز ایمنی صریح اضافه میکند تا پاسخ در سطح علمی کلی بماند و وارد دستورالعمل سنتز یا wet-lab نشود.
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["AVALAI_API_KEY"],
base_url="https://api.avalai.ir/v1",
)
prompt = """
سه ترکیب یا کلاس ترکیبی که باید برای پیشبرد تحقیقات در مورد
آنتیبیوتیکهای جدید، به ویژه علیه باکتریهای مقاوم، بیشتر بررسی کنیم، کدامند؟
به طور خلاصه توضیح دهید که چرا هر کدام امیدوارکننده است.
"""
response = client.responses.create(
model="gpt-5.6-sol",
reasoning={"effort": "high"},
instructions=(
"Formatting re-enabled\n"
"Answer at a high scientific level. Do not include synthesis steps, "
"dosages, protocols, or operational wet-lab instructions."
),
input=prompt,
)
print(response.output_text)import OpenAI from "openai";
const client = new OpenAI({
apiKey: process.env.AVALAI_API_KEY,
baseURL: "https://api.avalai.ir/v1",
});
const prompt = `
سه ترکیب یا کلاس ترکیبی که باید برای پیشبرد تحقیقات در مورد
آنتیبیوتیکهای جدید، به ویژه علیه باکتریهای مقاوم، بیشتر بررسی کنیم، کدامند؟
به طور خلاصه توضیح دهید که چرا هر کدام امیدوارکننده است.
`;
const response = await client.responses.create({
model: "gpt-5.6-sol",
reasoning: { effort: "high" },
instructions:
"Formatting re-enabled\nAnswer at a high scientific level. Do not include synthesis steps, dosages, protocols, or operational wet-lab instructions.",
input: prompt,
});
console.log(response.output_text);PROMPT=$(
cat <<'EOF'
سه ترکیب یا کلاس ترکیبی که باید برای پیشبرد تحقیقات در مورد
آنتیبیوتیکهای جدید، به ویژه علیه باکتریهای مقاوم، بیشتر بررسی کنیم، کدامند؟
به طور خلاصه توضیح دهید که چرا هر کدام امیدوارکننده است.
EOF
)
jq -n --arg prompt "$PROMPT" '{
model: "gpt-5.6-sol",
reasoning: {effort: "high"},
instructions: "Formatting re-enabled\nAnswer at a high scientific level. Do not include synthesis steps, dosages, protocols, or operational wet-lab instructions.",
input: $prompt
}' | curl https://api.avalai.ir/v1/responses \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $AVALAI_API_KEY" \
-d @-messages→input- پیام سیستمی →
instructionsیا آیتمdeveloper choices[0].message.content→response.output_text- برای ابزارها و خروجیهای چندوجهی،
response.outputرا بر اساسtypeبررسی کنید.
مثالهای موارد استفاده
برای مثالهای بیشتر از کاربرد مدلهای استدلالی در وظایفی مانند اعتبارسنجی دادهها، تولید روتین و تحلیلهای پیچیده، کتاب آشپزی AvalAI (در صورت وجود) یا منابع جامعه را کاوش کنید.
(در صورت وجود، به کتاب آشپزی AvalAI یا بخش مثالهای مرتبط پیوند دهید، در غیر این صورت این بخش را حذف کنید یا آن را کلی نگه دارید)